Schlagwort-Archiv: UlmAPI

Hydrantenmapping in OpenStreetMap – Schoener leben mit Fast-Linked-Open-Data

Ich hatte neulich zweieinhalb Wochen Urlaub und bin dabei unvermittelt in eine ganze Reihe von Rabbit Holes gefallen, in die ich mich ueber den Urlaub hinweg reingegraben habe. Das ueberrascht niemanden, die/der mich kennt, aber ich fand die Zusammenhaenge dazwischen so spannend, dass ich das mal aufschreiben wolle.

Alles fing mit einem Abend in der Feuerwehr an. Wir sollten ueber mehrere Abende alle Hydranten im Ortsgebiet anfahren, kontrollieren, spuelen und – wo noetig – Maengel aufschreiben. Fehlt ein Hinweisschild eines Unterflurhydranten, laesst sich ein Hydrant nicht vernuenftig oeffnen – oder aber auch, sind neue hinzugekommen, die wir nicht in unserem Hydrantenplan haben. In einer idealen Welt gaebe es natuerlich einen gut funktionierenden Austausch zwischen Gemeinde, Wasserversorger und Feuerwehr, so dass alle immer denselben Zustand dokumentiert haben. Aber ich muss ja niemandem erzaehlen, dass wir nicht in einer perfekten Welt leben.

Wo sind Hydranten – von analog zu digital?

Als ich 1999 zur Feuerwehr kam, bestand der Hydrantenplan aus einer fotokopierten Ortskarte, in die mit roter und blauer Farbe die Ueber- und Unterflurhydranten haendisch hineingemalt worden waren. Kurz darauf erstellten zwei Kollegen quasi ein „Lookbook“, in dem jeder der Hydranten mit einem Foto des Umfelds und einer kurzen Beschreibung je eine Karteikarte in einem Ordner bekam, die dann alle alphabetisch nach Strassennamen sortiert waren.

Beide Ansaetze haben Vor- und Nachteile: Bei der Uebersichtskarte sieht man stets den geographischen Kontext – gerade Unterflurhydranten tarnen sich aber gelegentlich recht gut in ihrer Umgebung, so dass man sie nicht immer leicht findet. Das Umfeldfoto hilft beim Auffinden, dafuer kann man ohne eine Kontext-Karte umliegende andere Hydranten uebersehen, die in einer anderen, aber nahen Strasse liegen.

Wegen eines anderen Urlaubs-Rabbitholes kam ich daher recht schnell auf die Idee, Umfeldfotos und Karte mit Koordinaten zu verbinden – und was laege da naeher, als eine gute Vermessung mit Hilfe von OpenStreetMap und Wikimedia Commons!

Die ersten Hydranten habe ich ganz klassisch nur per Smartphone positioniert. Da wir im temporaerhaus aber seit diesem Jahr einen echtzeitkinematikfaehigen simpleRTK2B-GNSS-Empfaenger samt passender Antenne haben, wollte ich das natuerlich etwas genauer haben 😉 Und so kam es zu einem unvorhergesehenen Projekt zwischen temporaerhaus und Feuerwehr Altenstadt.

Und was mappt man da?

RTK-Mapping: Positioniere Antenne ueber Hydranten, warte auf RTK-Fix, trage Position und Tags in OSM ein. Links ein alter Erhard-Ueberflurhydrant, rechts ein Unterflurhydrant.

Eigentlich alles, was in emergency=fire_hydrant auf OSM beschrieben ist. Um moeglichst alles abzudecken, kann man recht einfach zwischen Tags fuer alle Hydranten und Erweiterungen jeweils fuer Ueber- und Unterflurhydranten unterscheiden:

Fuer alle Hydranten

refDie Hydrantennummer auf dem Hinweisschild oder dem Hydranten selbst – sofern vorhanden
fire_hydrant:pressureDas laesst sich quasi nie ermitteln, d.h. hier einfach yes
fire_hydrant:positiongreen fuer Gruenflaeche, lane fuer die Fahrbahn, sidewalk fuer den Gehweg und parking_lot fuer Parkplaetze. Insbesondere bei Unterflurhydranten ist es super gut zu wissen, ob er auf einer Parkflaeche liegt!
water_sourcein der Regel main, also die abhaengige Loeschwasserversorgung
survey:dateDas Datum, an dem du diesen Hydranten eingetragen hast, YYYY-MM-DD
Auf solch einem Hinweisschild ist normalerweise haeufig eine Identfikationsnummer zu sehen. Hier aber leider nicht. Immerhin laesst sich der Leitungsdurchmesser 80 mm durch das „80“ rechts vom „H“ ablesen.

Speziell fuer Unterflurhydranten

fire_hydrant:typeunderground
fire_hydrant:diameterDas ist der Wert auf dem zugehoerigen Hydrantenschild – sofern das vorhanden ist! Falls keines vorhanden ist, siehe…
fire_hydrant:diameter:signed=noWenn kein Hinweisschild vorhanden ist. Dadurch lassen sich auch leicht die Hydranten ohne Schilder spaeter ermitteln

Speziell fuer Ueberflurhydranten:

fire_hydrant:typepillar
couplingsDie Anzahl der Festkupplungen, z.B. 2 oder 3
couplings:typeHier in der Regel storz
couplings:diametersNach den deutschen Kupplungsbezeichnungen, z.B. B;B oder B;B;A oder gar C;C;B (ja, das gibt es, und das festzustellen, ist spannend!)
manufacturer…irgendwann lernt man dann auch die Hersteller anhand der Logos oder Aufschriften zu unterscheiden und kann entweder den Hersteller oder die Wikidata-ID des Herstellers eintragen…
Links ein alter VAG-Hydrant mit „DN 80“ im Guss, rechts ein Erhard-nach-1996-Hydrant mit „DN 80“ auf dem Typenschild – das sagt aber nichts ueber die Versorgungsleitung aus.

Zu beachten bei Ueberflurhydranten: Die haben zwar bisweilen auch einen Rohrdurchmesser angegeben – bei den alten Hydranten im Guss im Hydrantenkoerper, bei den neueren auf den Typenschildern ausgewiesen. Dieser Durchmesser gilt aber nur fuer das Steigrohr, nicht fuer die Wasserversorgung selbst. Im OSM-Wiki wird daher davon abgeraten, diesen Durchmesser als Leitungsdurchmesser zu taggen!

Auch nur eine Karte – aber auswertbar

Darstellung in der OpenFireMap

Zunaechst hat man damit auf den ersten Blick nicht viel gegenueber der alten handgemalten Karte gewonnen: Die Hydranten sind in OpenStreetMap eingetragen, und in Ansichten wie z.B. dem „Humanitaer“-Layer kann man sie in der gerenderten Karte auf openstreetmap.org auch anzeigen – wobei die nicht einmal zwischen Ueber- und Unterflurhydranten in der Darstellung unterscheidet.

Auf OSMHydrant oder der OpenFireMap bekommt man jedoch schon jetzt eine genauere Darstellung und bei OSMHydrant per Klick auf den Hydranten auch weitere Informationen. Damit alleine liesse sich schon auf einem Alarmmonitor im Feuerwehrhaus anzeigen, welche Wasserentnahmestellen es im Umfeld eines Einsatzorts bei einem Brandalarm gibt!

Zu beachten: Die OpenFireMap wird nur woechentlich am Dienstag aktualisiert. Von der Eintragung bis zur Anzeige im Kartenlayer kann also bis zu einer Woche vergehen.

Links ein alter VAG-Hydrant mit nur zwei C-Abgaengen und einem B-Abgang – ungewoehnliche Konstellation, die wir bei der Erhebung „Hutzelmaennchen“ genannt haben. Man beachte die Oeffnungsvorrichtung oben, die nicht einmal einen Sechskant fuer den Hydrantenschluessel Typ B hat. Rechts ein moderner VAG Nova Niro 365 mit zwei B-Abgaengen.

Die eigentliche Magie beginnt aber, wenn man die so hinterlegten Daten weiter direkt aus der Overpass-API auswertet, beispielsweise mit OverpassTurbo. Beispielsweise koennen wir uns alle Unterflurhydranten ausgeben lassen, fuer die wir angegeben haben, dass sie keinen angegebenen Leitungsdurchmesser haben – also das zugehoerige Hinweisschild fehlt:

node["emergency"="fire_hydrant"]["fire_hydrant:type"="underground"]["fire_hydrant:diameter:signed"="no"]({{bbox}});

Genauso koennen wir spaeter so alle Hydranten abfragen, als JSON exportieren und weiterverarbeiten – beispielsweise, um eine Kartei mit einer Karte pro Hydrant daraus zu erstellen. Oder aber auch, um die „besonderen“ Hydranten zu identifizieren, die beispielsweise nur zwei C-Abgaenge haben.

Und auch die Versorgung von Gebaeuden laesst sich dadurch auswerten. OSMHydrant bietet einen ersten Eindruck, indem man dort Umkreise um Hydranten zeichnen kann – das hilft schon fuer einen groben Ueberblick. In der Realitaet lassen sich Schlauchleitungen aber nicht in Luftlinie von einem Hydranten verlegen, sondern muessen Strassen folgen – und koennen z.B. auch nicht einfach eine Bahnlinie queren.

Wunderbar passend bloggte Supaplex030 genau zum Zeitpunkt der Erhebung, wie man solch eine Analyse auch mit dem freien GIS QGIS erstellen und dabei entlang von Strassenzuegen arbeiten kann. So laesst sich beispielsweise pruefen, welche Strecken beispielsweise mit einer oder zwei Einpersonenhaspeln oder dem Rollschlauchmaterial auf einem Loeschfahrzeug entlang kartierter Wege erschliessen lassen – und wo die Strecken zu weit dafuer sind. Ein Bonuslevel waere natuerlich die Verbindung mit einem Digitalen Hoehenmodell, wo eine Haspel nicht mehr so einfach bergauf gefahren werden kann – aber prinzipiell geht auch das 😉

Bonuslevel: Fotos machen!

Ein modernerer Erhard-Hydrant mit zwei B-Abgaengen, Modellserie nach 1996

Was in so einer Karte dann aber noch fehlen wuerde, ist das Umfeldfoto, wie es in der frueheren, mit Word erstellten Kartei zu finden waere. Das koennen wir aber beheben!

Wir haben beim Einmessen auch Fotos eines jeden Hydranten mit der Hauskamera aus dem Technikpool des temporaerhaus gemacht und auf Wikimedia Commons in die Kategorie Fire hydrants in Altenstadt (Iller) geladen, die ich dafuer angelegt hatte. In der OpenStreetMap lassen sich solche Fotos ueber Photo Linking mit Objekten verknuepfen. Hier habe ich jedem Hydranten ueber den Tag wikimedia_commons die jeweilige Datei zugeordnet, z.B. File:2025 Altenstadt (Iller) Hydrant Memminger Straße 54.jpg

Hydranten, die zwar schon vermessen, aber noch nicht mit einem Foto versehen sind, lassen sich natuerlich auch einfach mit Overpass Turbo abfragen – man muss die Suche lediglich erweitern, dass kein wikimedia_commons-Tag vorhanden ist:

node["emergency"="fire_hydrant"][!"wikimedia_commons"]({{bbox}});

Spaeter lassen sich diese Fotos so extrahieren und weiterverwenden. Sowohl Hydranten als auch Gebaeuden liesse sich auch ein URL zu Panoramax zuordnen, einer Freien Alternative zu Google StreetView – damit liesse sich noch mehr Kontext herstellen, aber auch die direkte Ansicht einer Adresse vom Strassenniveau aus waere auf dem Einsatzmonitor moeglich, wenn ein Alarm eingeht!

Und jetzt… verlinkt?

Schon mit diesem Informationsbestand ist deutlich mehr moeglich, als das in den bisherigen Hydrantenkartierungen meiner Feuerwehr der Fall war:

  1. Die Koordinaten sind – vor allem durch die RTK-Vermessung – viel praeziser
  2. Wir haben Metadaten zu den Schildern (oder ihrer Abwesenheit), dem Nenndurchmesser der Zuleitung (sofern erfassbar), den Abgangsgroessen und vielem mehr
  3. Wir koennen diese Informationen automatisiert weiterverarbeiten
  4. Auswaertige Kraefte koennen ohne weiteres auf diesen Bestand in OSM zugreifen
  5. und auch andere MapperInnen koennen dazu beitragen, den Bestand zu verbessern, falls z.B. irgendwo ein Hydrant errichtet wurde, den wir gar nicht auf dem Schirm hatten!

Ein typischer Einwand koennte hier sein, dass ja der Datenbestand in der OSM jederzeit boeswillig veraendert werden koennte. Das ist prinzipiell richtig. In der Realitaet kommt das aber beruhigend selten vor. Dennoch koennte es sinnvoll sein, einen eigenen, geprueften Informationsbestand vorzuhalten – der auch Annotationen haben koennte, die in OSM nicht so gedacht sind.

Ein „Tele-Hydrant“ von Hawle. Der telefoniert nicht etwa, sondern er kommt ohne Standrohr aus: Ein Rohr mit zwei B-Abgängen lässt sich einfach herausziehen.

Man koennte beispielsweise all die eingetragenen und geprueften Koordinaten fuer sich vorhalten und periodisch mit OSM vergleichen: Kam etwas hinzu, wurde etwas veraendert, muss ich das pruefen, um meinen Informationsbestand valide zu halten? Was hierfuer in meiner Gemeinde fehlt, ist eben der ref-Identifier, den OSM hier eigentlich vorsieht. Weder die Hydrantenschilder noch die Hydranten selbst haben irgendwo eine ID angegeben, mit der man den Hydranten identifizieren koennte. Zu pruefen waere hier, ob es irgendwo tatsaechlich eine offizielle Nummer gibt, die man „nur“ anbringen und dann einpflegen muesste.

Man koennte hier natuerlich Wikidata missbrauchen, alle Hydranten dort als Datenobjekte anlegen und das als Identifier nutzen – das hielte ich aber schon fast fuer eine Zweckentfremdung des Projekts. Eine eigene Wikibase-Instanz fuer die Feuerwehr, um den bestaetigten Stand festzuhalten, faende ich… lustig! Das ordne ich mal unter „Seitenprojekt des Seitenprojekts“ ein, wenn mir mal langweilig sein sollte 😀

Spannend finde ich zuletzt aber, dass die gewachsene Cottage Industry rund um „Datenverwaltung in Feuerwehren“ eine sehr unterschiedliche Haltung zu so einer Verlinkung faehrt. Einzelne Softwaresysteme erlauben wohl eine Verbindung zu OSM, andere scheinen darauf zu setzen, dass man z.B. Hydranten rein in ihrem Oekosystem pflegt, auf dass man z.B. eine Tablet-Version ihrer Software kauft, die die Anzeige dieser Daten ermoeglicht. Das Charmante am OSM-Mapping finde ich, dass man damit zumindest nach aussen jegliche dieser Lock-Ins aufbricht: Egal woher eine ueberoertliche Unterstuetzung kommt und welche Systeme sie verwendet: Wenn sie OSM auswerten kann, bekommt sie zumindest die grundlegenden, wichtigen Informationen.

Und das zeigt fuer mich wieder einmal: Die ganzen Loesungen, die auf Vermarktung und Verwirtschaftlichung ausgerichtet sind, machen das Ergebnis meist eher nur shitty. Die Erfassung aller Hydranten in einer – zugegeben, im Kernort nur um die 4000 BewohnerInnen starken – Kommune hat mich einen Mittwochabend und einen Sonntagnachmittag gekostet. Eine Befahrung fuer Panoramax waere an einem weiteren entspannten Nachmittag moeglich und haengt gerade nur daran, dass die 360°-Kamera des temporaerhaus wegen eines Defekts die letzten Wochen ausgefallen war. Wenn wir nur allen Menschen mehr Freizeit ermoeglichen wuerden, waere so viel Cooleres, Besseres moeglich. Und ganz nebenher kann man dabei lernen, verschiedene Hydrantenhersteller auf einen Blick zu erkennen und etwas ueber das Hydrantenkartell zu lernen 😀

Wer war wie oft bei Lanz? – Schoener Leben mit Linked Data

Post by @dzu@hostsharing.coop
View on Mastodon

Ich habe mittlerweile ein kleines Hobby daraus gemacht, Abfragen zusammenzustellen, die Wikidata beantworten kann, bei denen ein Sprachmodell aber regelmaessig auf die Nase faellt.

Im Februar kam beispielsweise auf Mastodon die Frage auf, wie haeufig eigentlich welche Gaeste – und vor allem von welcher Partei – in den politischen Talkshows im Fernsehen eingeladen werden. Ein anekdotischer Kurz-Ausschnitt von Bluesky wirkte so, als gebe es da eine Tendenz. Aber viel besser als Anekdoten und Tendenzen ist natuerlich, der Sache datengetrieben auf den Grund zu gehen.

Ganz schnell kam in dem Thread auch jemand auf eine SPARQL-Abfrage, die mit Hilfe von Spinach erstellt wurde: Wie haeufig wurden Menschen einer gewissen Parteizugehoerigkeit zu Markus Lanz, Staffel 17 eingeladen. Die Abfrage ist schon nicht ganz verkehrt, nur tauchen da auch noch Kommunistischer Bund, SED und PDS auf – denn PolitikerInnen koennen im Lauf der Zeit nacheinander mehrere Parteizugehoerigkeiten haben. Sarah Wagenknecht wuerde hier beispielsweise fuer mehrere Parteien zaehlen, auch wenn sie „nur“ als Vertreterin des nach ihr benannten Buendnis eingeladen war.

Darueber bin ich aber dann auf das Modellierungsschema fuer TV-Serien und die Uebersicht aktuell laufender, in Wikidata abgebildeter Serien gestolpert. Und neben damals Pauline und aktuell den Pfefferkoernern sind es vor allem die Polit-Talkshows in den oeffentlich-rechtlichen, die dort abgebildet werden.

Ich hatte mich vor allem fuer Markus Lanz interessiert, deren Presseseite abgegrast um die Sendedaten und Gaeste in eine verarbeitbare Form umzuwandeln, und mich dann nach langer Zeit einmal wieder mit OpenRefine beschaeftigt, um daraus am Rande von Mit Wikipedia unterwegs in Neu-Ulm alles vorzubereiten, um fehlende Lanz-Episoden in Wikidata nachzutragen.

Das Schoene dabei ist: Viele der Talkshowgaeste sind „Dauerbrenner“ – es ist sehr selten, dass jemand zum allerersten Mal in einer der Shows landet. Hier mal jemand von der BundesschuelerInnen-Vertretung, dort mal jemand aus der Wirtschaft, das ist sehr ueberschaubarer haendischer Aufwand, fuer diese fehlenden Personen ein zugehoeriges Wikidata-Objekt anzulegen.

Kristina Dunz 2020 bei Hart aber Fair: © Raimond Spekking / CC BY-SA 4.0 (via Wikimedia Commons), Hart aber fair – 2020-02-10-4310, CC BY-SA 4.0

Und weil Menschen wie Raimond Spekking mit beeindruckender Ausdauer Menschen und Dinge fuer Wikimedia Commons fotografieren, ist es gar nicht so unwahrscheinlich, dass eine Person in Koeln bei der Aufzeichnung von „Hart aber Fair“ Raimond vor die Linse gelaufen ist – und dann gibt es auch ein passendes Foto dazu.

Mit den nachgetragenen Episoden konnte ich also eine Top-Gaesteliste fuer Markus Lanz ausgeben lassen, fuer die vergangene „Staffel 17“ (2024/25) absteigend sortiert nach Anzahl der Auftritte dort:

Diese Liste ist immer noch nicht perfekt. Zwar wird nur die Parteizugehoerigkeit ausgegeben, die kein Enddatum hat und es wird bei mehreren Eintraegen die mit einem Preferred Rank bevorzugt. Ex-Linken-MdB tauchen nur mehr mit ihrer aktuellen Partei auf – ganz unten kommt einem aber Juergen Trittin zweimal des Weges, bei dem auch noch die Mitgliedschaft im Kommunistischen Bund auf Wikidata verzeichnet ist – ohne Enddatum.
Das koennte man ohne weiteres Zutun auch noch eingrenzen, indem nur Parteien gewertet werden, die noch existieren, also kein Aufloesungsdatum in ihrem Datenobjekt haben. Oder bei Herrn Trittin die Mitgliedschaft bei den Gruenen als Preferred Rank setzen. „Schoener“ faende ich es natuerlich, wenn dort aber auch ein Enddatum zur Mitgliedschaft stuende – dafuer fehlt mir aber leider eine einsehbare Quelle.

Drei Dinge an diesem Ansatz finde ich so schoen, dass das einfach in die Rubrik „Schoener Leben mit Linked Data“ gehoert:

1.: Linked (Open) Data ist mehr als die Summe der einzelnen Teile!

Ich konnte bei der Vervollstaendigung dieser Abfrage auf unglaublich viel Vorarbeit anderer zurueckgreifen. Angefangen vom Modellierungsschema, aber vor allem auch die Vor-Arbeit bei den Datenobjekten der jeweiligen Personen, die bereits die Parteizugehoerigkeit und viele weitere Eigenschaften mitbringen.

Ich kann so etwas natuerlich immer auch von Hand machen: Eine Liste anlegen, in der ich Personen Parteien zuordne, und dann laeuft das fuer meine Auswertung. Aber nur dort. Und wenn jemand mal die Partei wechselt, muss ich das entsprechend anpassen. Oder, noch schlimmer, Faelle abfangen, in denen jemand im Zeitraum X zu einer Partei gehoert, im Zeitraum Y zu einer anderen. Und damit kommen wir zum zweiten schoenen Punkt:

2.: Jeder Beitrag zu Linked (Open) Data staerkt das Gesamtsystem – selbst dann, wenn ich irgendwann keine Lust mehr habe!

Als ich Talkshowfolgen nachgetragen habe, wollte ich damit eine Auswertung ueber Parteizugehoerigkeiten machen. Da aber die Personen-Datenobjekte viele weitere Eigenschaften maschinenauswertbar mitbringen, habe ich damit die Moeglichkeit zur Beantwortung vieler weiterer Fragestellungen geschaffen. Wer moechte, kann nun auch Statistiken ueber das Alter der Eingeladenen erstellen. Oder ueber das Geschlechterverhaeltnis. Oder zu sonstigen Fragestellungen, die mal auftauchen koennten.

Und da dieses Projekt nicht in einem git-Repo von mir herumliegt, ist es auch sehr viel einfacher fuer die tausenden Mitwirkenden z.B. bei Wikidata, ganz im Vorbeigehen dafuer zu sorgen, dass diese Informationen aktuell bleiben. Egal ob Parteizugehoerigkeit, das Nachtragen weiterer Folgen, das haengt alles nicht mehr alleine von mir ab, oder davon, dass ich einen Pull-Request fuer mein Projekt annehme.

Und schon die aktive Nutzung dieser Informationen sorgt fuer Qualitaetskontrolle im Vorbeigehen. Gerade solche Punkte wie die angeblich noch bestehende Mitgliedschaft von Juergen Trittin wird bei so einer Nutzung offenkundig – und kann nun direkt im Datenbestand korrigiert werden (wenn man denn die dafuer notwendige Sekundaerquelle findet).

3.: Versuch das mal mit ’nem Sprachmodell

Die Standarderwiderung gerade ist ja, dass man das doch sicher auch per LLM machen koenne. Und ich lade herzlich dazu ein, das mal zu versuchen und dann davon zu berichten 😀

Denn, die Besonderheit bei diesen Auswertungen: Die sind meist in dieser Granularitaet bislang von sonst niemandem gemacht worden. Das heisst, sie liegen nicht als fertige Liste im Web vor. Das heisst, ein Sprachmodell findet die nicht, um sie per RAG in seine Ausgabe zu konfabulieren. All-Time-Spitzenlisten fuer alle Polittalkshows gibt es im Web (auch dort an der Spitze: Elmar Thevessen). Aber nicht fuer einzelne Talkshows, oder fuer einen bestimmten, frei waehlbaren Zeitraum.

Das heisst andersherum auch: Je mehr Wissen der Welt wir als semantische Daten in einem Wissensgraphen erfassen, desto mehr dieses Wissens koennen wir auch verlaesslich, deterministisch und mit im Vergleich zu einem LLM laecherlichen Energieaufwand abrufen. Die Antwort wird nicht immer perfekt sein. Aber dann lassen sich die Fehler und Unvollstaendigkeiten in den Ausgangsdaten transparent und nachvollziehbar korrigieren.

Ein cooler Schritt in die Richtung, der das Nachtragen nicht nur von Talkshowfolgen erleichtern wuerde, waere zum Beispiel, wenn der oeffentlich-rechtliche Rundfunk die Informationen ueber solche Sendungen gleich in einem semantischen Format ausgeben wuerde. Bonus fuer die Verlinkung der Wikidata-Datenobjekte oder andere Identifier der Gaeste. Aber schon der erste Schritt waere schon gigantisch 🙂

What is in a street name – Schoener leben mit Linked Data

Eines meiner Lieblingsbeispiele, wenn ich ueber Linked Open Data spreche, sind Strassennamen. Das klingt auf den ersten Blick weit hergeholt, aber wer jemals groessere Mengen an Adressen mit einem Computer verarbeiten wollte, ist vermutlich irgendwann ueber die Liste der Falsehoods programmers believe about addresses gestolpert.

Die Quadrate in Mannheim (anstatt Strassennamen) sind dabei eher die Ausnahme. Dass in einer Gemeinde – in der Regel nach Eingemeindungen – mehrere Straßen mit demselben Namen existieren, oder dass in einer Ortschaft gar keine Strassennamen vergeben wurden, kommt dagegen relativ haeufig vor. Hilgermissen als Gemeinde mit 2200 BewohnerInnen, aber keinem einzigen Strassennamen, ist angesichts seiner Groesse so besonders, dass das DLF Nova einen Rundfunkbeitrag wert war. Neben Hilgermissen gibt es aber viele weitere kleine Oertchen, in denen die Haeuser einfach nur eine Hausnummer haben. Und egal, ob es einen Strassennamen gibt oder nicht: Sobald Menschen eine Adresse in irgendein Computersystem eingeben, wird es schnell haarig und fehlerhaft.

Adlitz: Schilder in die naechsten Staedte, aber keine Strassenschilder. Roehrensee, CC BY-SA 4.0, via Wikimedia Commons

Bei den Ortschaften ohne Strassennamen liegt das meist am Verwirrungsfaktor. Wir haben uns so sehr daran gewoehnt, dass eine Adresse aus Strasse, Hausnummer, Postleitzahl und Ortschaft liegt, dass es sich falsch anfuehlen wuerde, einfach nur „5, 95491 Adlitz“ zu schreiben – obwohl das eigentlich richtig waere.
Vermutlich alle diese Doerfer ohne Strassennamen wurden spaetestens durch die Gebietsreformen in den 1960er- und 70er-Jahren der naechstgroesseren Gemeinde zugeschlagen und verwenden auch die Postleitzahl dieser (oder einer anderen) groesseren Gemeinde. Daher liegt es nahe, diese Adresse stattdessen „Adlitz 5, 95491 Ahorntal“ zu schreiben.

Auch wenn das fuer die Postzustellung oder fuer die eigene Orientierung keinen praktischen Unterschied macht – richtig ist das nicht, und bei der maschinellen Auswertung kann so etwas zu Problemen fuehren. (Dass es zwar eine Gemeinde Ahorntal gibt, aber gar keinen Ort, der so heisst, ist noch einmal eine ganz andere Geschichte, die hier aber keine grosse Rolle spielt).

Denn, wie auch bei gesprochener Sprache sind wir als Menschen ganz gut darin, Mehrdeutigkeiten oder unpraezise Ausdruecke einfach passend zum Kontext einzuordnen. Wir lesen nicht einfach nur, was irgendwo steht und interpretieren das nur buchstaeblich, sondern wir interpretieren ohne gross darueber nachdenken zu muessen, was gemeint gewesen sein koennte. Aber bloederweise gehen wir andersherum auch beim Schreiben davon aus, dass ein Gegenueber schon wissen wird, was eigentlich gemeint ist. Und dass dieses Gegenueber nicht etwa ein Computer ist, der das Geschriebene vergleichsweise woertlich auslegt. Und dann wird’s wild.

Ganz offizielles Strassenschild – der Platz heisst aber offiziell „Augsburger-Tor-Platz“! Foto: -stk, CC BY-SA 4.0, via Wikimedia Commons

Zuletzt bin ich darueber gestolpert, als WikipedianerInnen aus dem WikiMUC und dem temporaerhaus gemeinsam bei einem Editathon die tausenden Feuerwehren in Bayern in Wikidata einpflegen wollten. Der Landesfeuerwehrverband hat eine Liste aller bayerischen Feuerwehren auf seiner Website, und die wird ganz offensichtlich von Menschen gepflegt, mit der Schreibweise der Adressen, die sie gewohnt sind. Mal wird im Strassen-Feld der Name des Ortsteils dem Strassennamen vorangestellt („Schwaighausen, Unterharter Straße 3“), mal steht im Gemeinde-Feld eine Kombi aus Ortsteil und Gemeinde („Triefenstein OT Homburg“) oder aber irgendwann ist womoeglich beim Feuerwehrhaus das Hausnummernschild abgefallen und alle sind sich einig, dass die Hausnummer „neben HsNr. 7“ scho so basst. Das ist schliesslich eine Feuerwehr, die kann man selbst in einem kleinen Dorf mit nur einer Garage fuer den Tragkraftspritzenanhaenger nicht so einfach uebersehen. Meist ist da ja irgendwas an die Wand gemalt oder es ist eine E57 auf dem Dach, also bittschoen, das wird man ja wohl finden, und die Feuerwehrdienstleistenden brauchen eh keine Hausnummer, wenn die Sirene mal geht, damit sie zu ihrem Feuerwehrhaus kommen.

Wenn dazu noch inoffizielle Abkuerzungen und vielfaeltige Interpretationen von Getrennt- oder Zusammenschreibung kommen, wird es endgueltig wild. Das temporaerhaus hat eine Adresse in der „Augsburger Straße“ – allein in unserer Community wurden sehr lange verschiedenste Varianten von „Augsburger-Str.“ ueber „Augsburgerstr.“, jeweils dann mit Varianten mit scharfem s oder Doppel-S verwendet (bis ich das nicht mehr ausgehalten und darum gebeten habe, dass wir das alle so schreiben, wie es richtig™ ist, damit ich besser schlafen kann).

Offizieller NameWas man so findet
Maximilian-Straßer-StraßeMaximilian-Strasse-Straße
Bürgermeister-Wolfgang-Brügel-StraßeBgm.W.-Brügel-Str.
St.-Ulrich-StraßeSt. Ulrich Str.
Dr.-Appelhans-WegDr.-Appelhansweg
Sankt-Johannes-Baptist-StraßeSt.- Joh.- Bapt.- Str.

Meine These ist, dass selbst bei den Datenbestaenden innerhalb einer Stadtverwaltung je Strasse im Schnitt deutlich mehr als zwei Schreibweisen ueber alle Systeme hinweg existieren, und bislang konnte das noch niemand widerlegen. Oft ist nicht einmal auf allen Strassenschildern der richtige Name der Strasse angebracht. Die „falschen“ Schilder sind bisweilen erkennbar alte Exemplare, die moeglicherweise vor einer Vereinheitlichung der Schreibweise aufgehaengt wurden. Aber nicht nur „neue“ Strassenschilder stimmen nicht immer mit dem amtlichen Namen ueberein, auch in Liegenschaftsverzeichnissen, Excel-Listen und moeglicherweise auch Fachverfahren tummeln sich mit grosser Sicherheit verschiedene Schreibweisen derselben Strasse.

Das kann automatisierte Auswertungen… schwierig machen. Der Versuch, aus den Adressen der Feuerwehren ueber Nominatim Geokoordinaten zu ermitteln, lief bei beeindruckend vielen der Eintraege gegen die Wand. Und selbst wenn man in einer Kommunalverwaltung ueberhaupt gleichzeitigen Zugriff auf alle Speicherorte haette, wo Strassennamen vorkommen: Eine Suche „gib mir alle Informationen, die irgendwie mit der Sankt-Johannes-Baptist-Straße zusammenhaengen“ wird spaetestens mit einer so kreativen Abkuerzung wie „St.- Joh- Bapt.- Str.“ (man beachte die Leerzeichen!) herausfordernd.

Nicht nur bei alten Strassenschildern schleichen sich Falschschreibungen ein. Diese Strasse heisst korrekt „Warmwässerle“. Foto: Looniverse, CC BY-SA 4.0, via Wikimedia Commons

Mit dem Konzept von Linked Data koennte man das ganz anders umsetzen. Die Sankt-Johannes-Baptist-Straße koennte ein Datenobjekt mit dem URI ld.bayern.de/location/street/081513121337 haben. Die 081513121337 koennte dabei eine hierarchische Bedeutung haben und dadurch Rueckschluesse auf Regierungsbezirk, Landkreis und Gemeinde geben – es koennte aber auch eine ganz beliebige, fortlaufende Nummer sein, so wie bei Wikidata. Und dieses Datenobjekt hat dann passende Eigenschaften – beispielsweise:

  • Ein Label mit dem Namen der Strasse. In mehrsprachigen Gebieten koennen das auch mehrere Label sein, mit maschinenlesbarer Bezeichnung, welche Sprache das jeweils ist
  • in welcher Verwaltungsgliederung es liegt – also z.B. die zugehoerige Gemeinde, mit einem Link zum Datenobjekt dieser Gemeinde. Moeglicherweise auch feiner granular mit Bezeichnung des genauen Ortsteils
  • weitere Identifier, z.B. die Nummer im Strassenverzeichnis der Gemeinde
  • moeglicherweise eine Auszeichnung, ob es sich um eine amtliche (gewidmete) Strasse mit offiziellem Strassennamen handelt, oder sowas wie den „Resis-Traktor-Weg“, den zwar alle so kennen und benutzen, den es aber „offiziell“ nicht gibt
  • Geoinformationen wie einen Linienzug, der die Strasse auf einer Karte definiert, oder einen Link auf ein solches Geofeature-Datenobjekt
  • die Information, nach wem oder was die Strasse benannt ist – zum Beispiel mit einem Link auf das Wikidata-Objekt

Oder ganz praktisch:

schema.org/nameSankt-Johannes-Baptist-Straße
schema.org/identifier081513121337
schema.org/containedInPlaceld.bayern.de/municipality/09775164
geosparql#hasGeometrygeo.ld.bayern.de/location/street/geometry/081513121337
schema.org/postalCode89264
P138Q40662 (Johannes der Täufer)

Solch eine Datenhaltung hat gleich in mehreren Aspekten grossen Charme. Die Idee ist, dass – egal wo in der Kommunalverwaltung ein Strassenname eingegeben werden soll – per Autovervollstaendigung anhand des Namens das passende Datenobjekt aus diesem Linked-Data-Strassenregister gesucht wird. Auf der „Bildschirmvorderseite“ und ueberall, wo es in Texten und Adressen in der Folge um diese Strasse geht, wird stets das Label, also der Strassenname angezeigt. Der ist dadurch immer auch der „richtige“, aber sonst aendert sich weiter nichts.

Bei der Speicherung wird aber immer der URI auf diese Strasse abgelegt. Und das heisst, dass viel verlaesslichere Datenabfragen moeglich sind: Ueber alle Dinge – Firmen, Gebaeude, Einrichtungen – in genau dieser Strasse. Ueber alle Strassen in einer Gemeinde. Oder auch – falls auch das passend codiert ist – ueber alle Strassen in einem bestimmten Ortsteil, ganz ohne Namenskonventionen, wie der Ortsteil anzugeben ist. Und wird einmal eine Strasse umbenannt, zum Beispiel, weil ein Namensgeber spaeter als unwuerdig befunden wird, muss nur im Linked-Data-Strassenverzeichnis das Label geaendert werden, und in kuerzester Zeit ist diese Aenderung einheitlich an allen Stellen vollzogen.

Hildegards gibt es viele – gemeint ist hier Q234410 (Wikipedia). Foto: Looniverse, CC BY-SA 4.0, via Wikimedia Commons

Wenn ueber Linked Data eindeutig bezeichnet wird, nach wem oder was eine Strasse benannt ist, ist auch viel leichter nachvollziehbar, nach welchem Frieden die Friedenstrasse in Neu-Ulm benannt ist, ohne dafuer zum Strassenschild gehen und die Legendentafel darunter lesen zu muessen. Auch die OpenStreetMap hat eine passende Eigenschaft NamedAfter, in die man die passende Wikidata-ID eintragen kann. Mit MapComplete kann man das relativ komfortabel fuer die Strassen in der eigenen Stadt eintragen.

Hier sieht man dann auch die Magie verlinkter Datenbestaende in der Praxis. Denn weil die Datenobjekte der Personen, nach denen eine Strasse benannt wurde, meist auch weitere Informationen wie z.B. das Geschlecht angeben, laesst sich mit Linked Open Data auch ganz durchautomatisiert und ohne weiteres Zutun darstellen, wie eigentlich das Geschlechterverhaeltnis bei der Strassenbenennung ist – so wie auf dieser interaktiven Karte von Frankfurt. Vor beinahe 11 Jahren hatte unsere Open-Data-Ehrenamtsgruppe das noch mit viel Handarbeit machen muessen und die Karte war auch irgendwann tot und die Daten versauerten – der EqualStreetNames-Ansatz laesst sich mit wenig Handarbeit uebertragen, und die Datenpflege in Linked Open Data hilft am Ende allen auf der ganzen Welt, auch wenn das Kartenprojekt einmal untergehen sollte!

Noch nicht ganz fertig: Eine interaktive Karte zur Geschlechterverteilung bei der Strassenbenennung in Neu-Ulm

Letzte Woche war ich beruflich fuer einen Vortrag (Slides) auf der TRANSFORM-Konferenz in Bern, wo ich viele inspirierende Diskussionen ueber Linked Data fuehren konnte. In einem Gespraech mit einem beeindruckend tief in der Materie arbeitenden Menschen von der Schweizerischen Bundeskanzlei liess ich nebenher das Strassenbeispiel als praktische Anwendung von LOD mit Nutzen fuer die Verwaltung fallen. Und mein Gegenueber blickte mich ueberrascht an – ich weiss rueckblickend nicht, ob es verwundert oder gar mitleidig war – und sagte lapidar, dass es das in der Schweiz natuerlich bereits gebe.

Fuer jede einzelne Strasse.

Ich versuchte, nicht sogleich aufzuspringen und mich in den naechstgelegenen Fluss zu stuerzen, sondern liess mir zeigen, dass in der Tat, es fuer jede Strasse in der Schweiz ein Datenobjekt gibt, zum Beispiel fuer den Philosophenweg in Bern, samt der zugehoerigen Geometrie. Und falls das Verlangen fuer die Sache nach dem Fluss nicht nachlasse, faende ich natuerlich auch die Aare als Datenobjekte, wobei es sich hier zu meinem Wohl explizit um Badegewaesser handle.

Die jeweils uebergeordnete Entitaet „Bern“ verlinkt natuerlich auch auf das Wikidata-Item zu Bern. Wie sich das halt gehoert, wenn man Dinge bitte gleich richtig macht.

Es faellt mir schwer, den Zustand meines Emotiotops in diesem Moment zu beschreiben. Aehnlich ging es mir spaeter, als ein Mitarbeiter der Statistik bei der Stadt Zuerich mich neugierig fragte, wie viele kommunale Statistikabteilungen in Deutschland denn in ihren Prozessen mit Linked Data arbeiten wuerden, so wie sie, ganz natuerlich.

Zack. Bumm. Geht einfach. Screenshot von https://geo.ld.admin.ch/sparql/

Ich habe dann versucht, ueber diesen mentalen Zustand hinwegzukommen, indem ich eine SPARQL-Abfrage gebaut habe, um mir die Geometrien aller 822 Strassen in Bern ausgeben zu lassen, was in rund einer Sekunde… einfach so ging. Alle Haltestellen in Bern bekommt man in 0,225 Sekunden. Auch einfach so. Ganz selbstverstaendlich. Und ganz nebenbei, wenn in der Schweiz Linked Open Data veroeffentlicht wird, folgt das – natuerlich – verbindlich dem URI-Schema *.ld.admin.ch/*. Und es sei auch alles dafuer technisch notwendige ausgerollt, damit das funktioniert und dauerhaft stabile URIs sicherstelle, wie sich das ja auch gehoert. Nicht etwa, dass sich irgendwie Namen und damit auch URIs von Ministerien aendern (wie das bis heute selbst in DCAT-AP.de geschieht!) und dann fuehren auf einmal sowohl Website-URLs wie auch URIs ins Nirvana. Also so, wie das heute in Deutschland immer noch gang und gaebe ist und woran auch ueberraschend viele Digital-Lobby-Organisationen ueberhaupt gar keinen Anstoss nehmen.

Waere das bei uns auch so ganz normal, koennte man mal eben im Vorbeigehen ganz viele andere Schmerzen einfach so loesen.

Auszug aus dem Strassenverzeichnis von 1954, das die Open-Data-Community im temporaerhaus freundlicherweise von der Stadt Neu-Ulm bekommen hatte – der Ist-Zustand besteht immer noch aus Texten, manchmal eben auch auf Schreibmaschine geschrieben. Weitergeholfen fuer die Ueberfuehrung in Linked Open Data hat das dennoch immens!

Wer datenjournalistisch Sachverhalte auf Karten darstellen moechte, kennt naemlich dieses Problem auch: Geographische Raumbezuege sind haeufig nur eben als textliche Beschreibungen zugaenglich. Egal ob es darum geht, Unfallschwerpunkte auf einer Karte darzustellen, wie Jan-Georg Plavec berichtet (LinkedIn), oder um regelmaessig wiederkehrende Aufgaben wie die Darstellung von Wahlergebnissen auf einer Karte: Oft gibt es die Voraussetzungen fuer solch eine Kartendarstellung gar nicht maschinenlesbar.

Der Zuschnitt der Wahlkreise bei einer Wahl ist dabei noch vergleichsweise einfach: Das ist eine Liste von Kommunen oder Stadtbezirken, und dafuer gibt es meistens irgendwelche Geoshapes, die sich dafuer halbwegs angenehm verwursten lassen (Beispiel: Die Liste der Stimmkreise in Bayern). Sobald es aber um die Wahl- bzw. Stimmbezirke innerhalb einer Gemeinde geht, kann es anstrenged werden. Die liegen naemlich viel zu oft immer noch nur als Listen der in ihnen befindlichen Strassen vor. Und selbst an diese Listen zu kommen, kann aufwaendig sein, wie diese Dokumentation bei der OpenStreetMap zeigt.

Hat nichts mit Stimmbezirken zu tun, aber erwaehnt nochmal die Hildegardstr.: In dieser Version des Neu-Ulmer Strassenverzeichnis von 1978 sind auch die vorherigen Strassennamen erkennbar. Nochmals vielen Dank an die Stadt Neu-Ulm!

Aus Sicht der Wahlbehoerde ist das auch nachvollziehbar. Denn von einer Kartendarstellung hat sie ja fuer die Aufstellung des Stimmverzeichnis erst einmal gar nichts: Wenn ihr die Liste der jedem Wahllokal zugehoerigen Strassen vorliegt, kann sie aus dem Meldeverzeichnis die jeweiligen Listen der Wahlberechtigten erstellen – fuer ihren Auftrag hat sie damit alle Informationen, die sie braucht. Wenn es eine geographische Darstellung der Wahlbezirke anhand der Strassenlisten gibt, ist das womoeglich nur ein Zusatzaufwand. Manchmal leistet man sich den, manchmal aber auch nicht. Und wenn es eine geographische Darstellung gibt, heisst das immer noch nicht, dass die dafuer notwendigen Daten auch z.B. von Datenjournalist*innen wiederverwendet werden koennen.

Bei der Recherche gefunden: Eine immerhin (geo)graphische Darstgellung der Wahlbezirke in Regensburg, im PDF der Wahlbezirke sortiert nach Strassennamen. Das Dokument ist mit LaTeX generiert und ich bin jetzt total neugierig, wie die das machen!

Waeren die Strassen aber Datenobjekte, mit verknuepfter Geometrie, waere in beide Richtungen vieles so viel einfacher. Fuer den Zuschnitt der Stimmbezirke waeren Neuordnungen quasi live moeglich: Mit Drag und Drop auf der Karte (und der nur verwaltungsintern zugaenglichen Linked-Data-Verknuepfung zu Meldedaten) liessen sich Neuzuschnitte und die Auswirkungen auf die Gesamtzahl der Wahlberechtigten ganz einfach simulieren – oder auch durch mathematische Optimierungsverfahren Vorschlaege machen. Und ist die Ausdehnung einmal festgelegt, waere es ueberhaupt kein Problem mehr, diesen Zuschnitten geographische Umringe zuzuordnen.

Wir muessten dafuer nur die Informationen aus der Textform in das Linked-Data-Prinzip ueberfuehren. Das ist keine Zauberei, sondern einfach nur Infrastrukturarbeit, fuer die es den notwendigen Sachverstand fuer IT-Architektur und Datenstrukturen braucht. Und die bereits auf mittlere Sicht allen Beteiligten beeindruckend viel Handarbeit sparen und Fehlerquellen vermeiden wuerde.

Lieber Clever als Smart: Civic Tech fuer Menschen

Drei (plus x) Lese- und Ansehempfehlungen, die mir gestern nach und nach in den Twitterfeed gepurzelt sind und ebenfalls zur Frage passen, wie Civic Tech weitergesponnen werden kann.

Erstens das Boston Smart City Playbook, das schon gleich mit einem Kracher anfaengt:

The age of the “Smart City” is upon us!

It’s just that, we don’t really know what that means. Or, at least, not yet.

So far, every “Smart City” pilot project that we’ve undertaken here in Boston has ended with a glossy presentation, and a collective shrug. Nobody’s really known what to do next, or how the technology and data might lead to new or improved services.

Es folgt ein Rant ueber Vertriebsdrohnen von „Smart City“-Verkaufsbueros, eine Rueckbesinnung auf die Menschen, um die’s gehen soll, dass es nicht noch eine Plattform braucht (!!! zefix!!!), und dass im Zweifel eine „Clevere“ Stadt besser ist als eine „Smarte“: Mit einem Prototypen, einer intelligenten Strassenlaterne. Kleinen Spielplaetzen, die spaeter vielleicht hochskaliert werden, wenn sie sich bewaehren. Anstelle von Alles-oder-nichts-Megaprojekten.

Zweitens The Engine Room’s Advent Calendar mit einem Lesetipp fuer jeden Tag. Beispielsweise, dass „Startup-Kultur“ eine denkbar depperte Denkweise und Rahmenbedingung fuer gesellschaftsveraendernde Projekte ist. Dass „Innovation“ vollkommen ueberbewertet ist und „Wartung und Unterhalt“ eigentlich die wichtigeren Buzzwords sein sollten. Oder dass im Westen nach wie vor nicht-wohlhabende nicht-weisse Nicht-Akademikerinnen (hier: spezifisches Femininum) vergleichsweise wenig von Civic Tech haben.

Um Ausschluesse geht es – drittens – auch in Programming is Forgetting: Towards a New Hacker Ethic. Der etwas mehr als 20minuetige Vortrag (siehe oben) ist hier komplett transkribiert und lohnt sich zu lesen, gerne auch haeppchenweise. Am Beispiel einer Anekdote um die juengst mit der Presidential Medal of Freedom ausgezeichneten Margaret Hamilton zerlegt Allison Parrish Stueck fuer Stueck die „Hackerethik“, wie sie Steven Levy 1984 in seinem Buch “Hackers” dargestellt hatte. Nach einem Exkurs ueber soziale Kontexte stellt sie den urspruenglichen Lemmas jeweils eine Frage gegenueber. Und ich finde sie grossartig:

allison-parrish-programming-forgetting-26

(danke @lorz und @mjays fuer die Links. Ich weiss leider nicht mehr, von wem ich den Vortrag retweeted bekam.)

Von Hackathons und Communityfoerderung

Foto: Sebastián Laraia für Deutsche Bahn / CCBY4.0

Foto: Sebastián Laraia für Deutsche Bahn / CCBY4.0

Mittlerweile hat sich herumgesprochen, dass Hackathons eine ganz gute Moeglichkeit sind, die eigene Stadt, Behoerde oder Konzern zu oeffnen und sich frischen Wind in die verstaubten Hallen zu holen. Das BMVI lud derletzt zum zweiten Mal zum Data Run, und die Deutsche Bahn hatte gestern den fuenften Hackathon binnen 20 Monaten ueber die Buehne gebracht. Nicht schlecht, koennte man sagen.

Was mir aber schon bei unseren OpenCityCamps auffiel: Nach einer Weile scheint sich das etwas totzulaufen. Die ausrichtende Einrichtung darf von Mal zu Mal neue Datenquellen freischaufeln, um sich nicht dem Vorwurf auszusetzen, es bewege sich nichts mehr. Ob diese – muehsam irgendeiner grantelnden Fachabteilung abgetrotzten – Daten dann helfen, tatsaechliche Probleme echter Menschen zu beheben, weiss vorher kein Mensch. Und irgendwann ist auch der Punkt erreicht, an dem die naechsten grossen zu beackernden Baustellen einfach gar nicht mehr an einem 24-Stunden-Hackathon bearbeitet werden koennen.

Vor diesem Hintergrund deswegen mal ein paar halbgare Einwuerfe, was mir die letzten eineinhalb Jahre so durch den Kopf gegangen ist:

  1. Mit das wichtigste Ergebnis einer Open-Data-Veranstaltung ist, dass sich die Teilnehmer*innen live treffen und austauschen. Egal ob Freiwillige mit Ministeriumsleuten, Ministeriumsleute mit Konzernbeschaeftigten oder sonstwas: Diese Aufeinandertreffen motivieren, inspirieren und sorgen fuer die notwendige regelmaessige Hirnbelueftung mit frischen Ideen. Fuer diesen Austausch muss genuegend Zeit und Raum vorhanden sein. Das haben wir als blutjunge Fachschaftler*innen bei der Konferenzorga zwar gelernt, bei Behoerden darf man von dem Wissen aber nicht unbedingt ausgehen 😉
    Hierzu gehoert auch: Wenn ein Ministerium, eine Landeseinrichtung, ein Staedtetag oder sonstwer eine schicke Austauschveranstaltung macht, dann sollte sie unbedingt auch die Freiwilligen aus der Community mit einladen. Die OPEN! hat das nach der Kritik von 2015 dieses Jahr gemacht, das VDV-Verkehrscamp ebenso. Weiter so!
  2. Irgendwann ist jedoch der Punkt erreicht, an dem das klassische Hackathon-Wettbewerbs-Format nicht mehr traegt. Erstens, weil beim Coden immer die Frage im Raum steht, mit welchem Projekt man denn Preise gewinnen kann. Anstelle der Frage, was nuetzlich, wichtig und sinnvoll waere. Zweitens, weil es das Potenzial verschenkt, gemeinsam mit den vielen tollen, kompetenten Leuten mal ein Wochenende lang strategisch wichtige Dinge auszuarbeiten. Mal dieses Werkzeug uebersetzen. Oder dieses Tool schreiben, das es noch nicht gibt und das bisher jedes Mal irgendwie fehlte. Gruppenuebergreifende Metaprojekte, bei denen jede Gruppe einen kleinen Teil fuer das Gesamtprojekt entwickelt
  3. Aus 1) und 2) folgend: Der konsequente naechste Schritt waere, genau solche Zusammenkuenfte zu foerdern. Bei denen nicht kompetitiv Prototypen gebastelt, sondern gemeinsam die Dinge beackert werden, die fuer die Weiterentwicklung von Open Data in Deutschland wichtig sind.
  4. Die Teilnahme an den Aktionen in 3) darf nicht mehr nur auf den Schultern von Leuten mit viel Zeit oder ausreichend Geld oder beidem ruhen. Die Freiwilligen, die sich ein Wochenende um die Ohren schlagen, duerfen nicht auch noch aus eigener Tasche Anreise und Unterkunft bezahlen muessen, oder per Anhalter anreisen und dann irgendwo auf WG-Sofas pennen. Wer quer durch Deutschland zu so einer Aktion reist, gibt fuer solch ein Wochenende je nach Zeit-Geld-Tradeoff irgendwas zwischen 30 und 300 EUR aus. Das kann sich nur eine ueberschaubare Gruppe privilegierter Leute leisten.

An jeder Ecke wird derzeit haufenweise Kohle auf Big Data, Blockchain 4.0 in der Cloud as a Service und andere Ideen mit ueberschaubarer Halbwertzeit geworfen, die aus irgendeinem Berater-Powerpoint gefallen sind. Foerderfunds werden ins Leben gerufen, auf die sich aufgrund der Rahmenbedingungen letztlich eh nur die ueblichen Verdaechtigen bewerben und die Kohle in bekannter Manier zum Fenster rauswerfen.

Ich wage zu behaupten: Die Foerderung von Veranstaltungen wie in 3) beschrieben und die Vergabe von Reisestipendien fuer Open-Data-Aktivist*innen haette ein deutlich besseres Preis-Leistungs-Verhaeltnis. Da wuerde auch wirklich ein Bruchteil der 100 Millionen des BMVI reichen.

Strippen ziehen

Nach einigen Wechseln in der Belegung wohnen aktuell ueber 100 aus Syrien nach Deutschland gefluechtete Menschen in der provisorischen Unterkunft Keplerhalle, und seit zwei Monaten werden die dortigen Bewohner per Freifunk mit Internet versorgt. Leider jedoch mit nur einem einzigen Richtfunk-Uplink, der zudem immer wieder mal rummuckt.

Bildschirmfoto vom 2016-01-14 00:05:08

Um so cooler, dass sich am Wochenende eine weitere Studi-WG im direkten Umfeld der Halle gefunden hat, die seit Dienstag einen (nach einer vorbildhaften Ulmerin benannten) gespendeten Router bei sich beherbergt. Damit dessen Signal auch in der Keplerhalle empfangen werden kann, musste ich gestern nochmal 50 Meter LAN-Kabel in der Halle verlegen – wofuer ich binnen einer halben Minute 10 Helfer hatte, die gemeinsam die Kabelrolle entwirrten und per Raeuberleiter das Kabel durch die ehemaligen Basketballkorb-Halter faedelten.

Sitzt am suedlichen Hallenfenster und beleuchtet ausserdem die Tramhaltestelle: Kepler3-WR841ND. Man beachte den Billig-PoE-Injector.

Sitzt am suedlichen Hallenfenster, vernetzt ueber die Strasse zu ResiWeglein-WR841ND und beleuchtet ausserdem die Tramhaltestelle: Kepler3-WR841ND. Man beachte den Billig-PoE-Injector.

Nach anfaenglichem Schluckauf und Neuverlegung zweier Kabel ist die Halle nun redundant und mit doppelter Bandbreite ans Internet angeschlossen – leider jedoch immer noch mit nur maximal 20 Mbit/s, die sich die zwischen 50 und 70 eingeloggten Clients teilen muessen. Als interessanter Nebeneffekt ist nun auch die Haltestelle Justizgebaeude mit Freifunk versorgt – was ein zweischneidiges Schwert ist, da etwaige dort eingeloggte Clients ebenfalls zur Netzlast beitragen. Ich habe vom Freifunk-Unterstuetzungsverein das Go bekommen, mit besseren Antennen und ggf. staerkerer Hardware die Anbindung noch etwas robuster zu gestalten.

Redundanz. Deutlich sichtbar: Kepler1-WR841ND nimmt die meisten Clients auf.

Redundanz. Deutlich sichtbar: Kepler1-WR841ND nimmt die meisten Clients auf, und LAN-Kabel sorgen fuer Vernetzung im gruenen Bereich.

This is The Internet™

This is The Internet™

Ich moechte helfen

Prima! Wenn du – egal wo in Ulm und Umgebung – zum Freifunk-Netz beitragen moechtest, kontaktiere die Freifunk-Gruppe, oder mich direkt. Wenn du ein Cafe, einen Laden, sonst eine Einrichtung in und Ulm kennst, die fuer ihre Kund_innen freies Internet ueber Freifunk anbieten moechte, genauso. Und der Freifunk-Unterstuetzungsverein freut sich ueber jede Spende, die er bekommt.

Lessons learned

Mit der Verkabelung des dritten Routers ist das Netz in der Keplerhalle nun endlich so ausgelegt, wie wir das eigentlich von Anfang an vorhatten:

  • Die drei Router (841ND) sind per Mesh-on-LAN miteinander vernetzt und funken jeweils auf verschiedenen, nicht ueberlappenden Kanaelen (1, 6, 11). Somit verteilen sich die Geraete halbwegs auf die einzelnen Router
  • Nur der direkt ueber die Olgastrasse hinweg meshende Knoten ist mit aktiviertem Mesh-on-WLAN auf Kanal 1; den mit der Nanostation-Richtfunkstrecke verbundenen werde ich mittelfristig auch ins Halleninnere verlegen und Mesh-on-WLAN deaktivieren. Das sorgt fuer mehr Freifunk-Airtime.

Folgende Erkenntnisse koennten vielleicht fuer Nachahmer_innen interessant sein:

  • Stromversorgung kann ein Problem sein. Hinten in der Halle gibt es keine einzige funktionierende Steckdose, vorne sind sie rar. Dreifachsteckdosen und Billig-PoE-Injektoren (ca. 2–4 EUR pro Stueck) sind eure Freunde. Klappt bei den 841ND auch ueber ein 50-Meter-Kabel.
  • Unterschaetzt die Kabellaengen nicht. Das 50-Meter-Patchkabel war letztlich ziemlich exakt 5 Meter zu kurz, um es an der Hallenwand entlang bis ins Buero zu fuehren. Abhilfe schaffte etwas wilde, direkt gespannte Verkabelung von Basketballkorbhalter zu Gelaender. Kabel-Kabel-Kupplungen zum Aneinanderstueckeln sind problematisch, wenn PoE-Injektoren verwendet werden (fuehrte zu Reboot-Cycle)

Wilde, freie Verkabelung (Symbolbild)

Wilde, freie Verkabelung (Symbolbild)

  • Man kann selten genug Gaffa und/oder Kabelbinder haben
  • Vielleicht ist es kein Fehler, die Router einzuhausen oder die Kabel wahlweise mit Aufkleberchen zu versehen, wo sie hingehoeren, oder gleich festzutapen. Ich belege den Switch der 841ND in der Regel der Reihe nach so: LAN – Mesh – Mesh – Freifunk (letzteres zum Testen per Kabel). Wenn nun der Uplink ausfaellt und der per Kabel in die vermeintliche LAN-Buchse 2 anstelle des Uplinks gesteckt ist, verleitet das offenbar Leute dazu, den (Mesh-)Uplink in die WAN-Buchse zu stecken. Ich habe jetzt „einfach“ mal auch die WAN-Buchse mit Mesh belegt – was nichts dagegen half, dass jemand mit dem Ubiquiti-Poe-Injektor einen armen 841ND bebrutzelt hat…
  • Und, ultrawichtig: Testet euren geplanten Aufbau so gut und umfangreich es geht „trocken“ zuhause, und zwar in moeglichst allen Facetten. Tauschgeraete sind kein Fehler, um mal kurzzeitig Testkonfigurationen auszuprobieren, ohne gleich den einzigen Uplink lahmzulegen. Die Leute bauen auf euch.

Freifunk fuer Gefluechtete in Ulm

IMG_20151114_174125863

Waehrend die Stadt nun nach langer Zeit endlich geschafft hat, fuer sage und schreibe 205.000 EUR Investitionskosten „freies“ WLAN an vier Punkte der Stadt zu bringen, waren viele Gefluechtete in den Ulmer Unterkuenften immer noch vom Internet abgeschnitten – Abhilfe schafften da bislang nur freie Hotspots bei diversen Schnellrestaurants und Freifunk-Knoten wie der am Muensterplatz.

Der sehr aktive Blaubeurer Teil der Ulmer Freifunk-Community hatte sich vor diesem Hintergrund wohl schon sehr frueh an die Geschichte mit Mohammed und dem Berg erinnert, und einfach umgekehrt Freifunk-Knoten in die dortige Unterkunft gebracht. Da die Kommunen offenbar keinen eigenen Internetanschluss fuer die Unterkuenfte stellen koennen, wurden kurzerhand nach Absprache mit  dem Landratsamt Freifunk-Router in die Unterkunft getragen, die von bis zu drei Funkstrecken von ausserhalb mit Internet versorgt werden.

In Ulm mahlten die Muehlen dagegen deutlich langsamer. Erst nach Intervention des Eskalationsbeauftragten in der Stadtverwaltung gab es gruenes Licht, ueberhaupt Router in den Gebaeuden einstecken zu duerfen – und dann ging alles ganz schnell.

IMG_20151113_163109590

Nach einem Rundruf ueber die Ulmer Freifunk-Mailingliste fanden sich innerhalb kuerzester Zeit mehrere Leute, die bereit waren, substanzielle Summen an den Freifunk-Unterstuetzungsverein zu spenden, damit die notwendige Hardware beschafft werden konnte. Dezentral entstand eine Beschaffungsliste, und in der letzten Woche troepfelte nach und nach ein ganzer Haufen Material bei mir ein. Denn ich war der naechstgelegene Mensch aus der Community, der Sichtkontakt zur Unterkunft Keplerhalle hat – wenig mehr als 200 Meter sind es von unserem Dach bis zur Halle.

IMG_20151114_172804082Heavy Lifting fuer die Strecke uebernehmen zwei Ubiquity Nanostation M5, die aus den Spenden bestellt wurden, und als Wireless Bridge eingerichtet sind, d.h. sie verhalten sich quasi wie ein Netzwerkkabel. An meinem Ende haengt die Nanostation hingetuedelt professionell unter dem Dach; per LAN-Kabel und via PoE-Injektor ist sie dann an einen auf Meshing konfigurierten LAN-Port meines etwas schwachbruestigen (841N) Freifunk-Routers angeschlossen.

IMG_20151114_174422677

Hallenseitig hatten wir uns erst Konstrukte mit Mast auf Flachdach und Kabeldurchfuehrungen durch Fensterrahmen ausgedacht. War alles aber gar nicht noetig – die Nanostation hatte schon Funkkontakt, wenn ich sie nur halbwegs hinter dem Fenster in Richtung meines Hauses ausgerichtet hatte. Also kam der Mast gestern abend kurzerhand einfach auf das Fensterbrett – reicht.

IMG_20151114_172719760Von der Nanostation geht dann das ganze 1:1 umgekehrt wie bei mir daheim: LAN-Kabel per Mesh-on-Lan in den Router „Kepler1“, und weil gestern abend kein passendes Kabelmaterial fuer Hallenverkabelung da war, steht „Kepler2“ einfach innerhalb der Halle und vermesht sich per WLAN. „Kepler3“ sollte eigentlich noch an das andere Hallenende, der Zugang zum passende Ort ist aber momentan etwas abenteuerlich.

Was prima ging

  • Richtfunk per Nanostation ist ein Traum. Kein Vergleich zu Konstruktionen mit Consumer-Plasteroutern
  • Als das Gruenlicht erstmal von der Stadt gekommen war, war alles kein Problem mehr. Die Sicherheitsleute in der Unterkunft waren gerne bei allem dabei, was wir machen wollten – sicher nicht ganz uneigennuetzig 😉
  • noch viel beeindruckender: Wie zwar teilweise chaotisch, aber schnell und selbstlos alle moeglichen Leute dezentral zusammengearbeitet haben, um das Material auszusuchen, zu finanzieren und zu bestellen!

Was noch besser geht

  • Momentan laeuft alles ueber unseren WG-Internetanschluss, der nicht der allerschnellste ist. Weitere Versorgungspunkte in der Umgebung bedeuten mehr Ausfallsicherheit
  • Der gesamte Traffic laeuft ausserdem ueber den einen, schwachen Plasterouter, der gar nicht mehr hinterherkommt, die Verbindungen zu verschluesseln. Das limitiert die maximale Datenrate auf etwa 3 Mbit/s
  • die Router in der Halle wuerde ich gerne noch per Mesh-on-LAN untereinander verkabeln, um das Netz zu stabilisieren und mehr Durchsatz zu ermoeglichen
  • Wenn die offenporigen Dachpfannen nass sind, geht die Verbindungsqualitaet runter. Dank der Nanostations ist das aber ein Luxusproblem, das heisst dann 10 Mbit/s statt 100 😉
  • Ab und zu bricht die Verbindung zur Halle aber auch einfach mal weg. Mein Router gibt an, noch einen lokalen Nachbarn zu haben, aber auf der Karte ist nichts zu sehen, und es laeuft auch kein Traffic mehr durchs Netz. Ursache ist unklar.

IMG_20151114_174149986

Nicht zuletzt wuerde ich auch gerne die Unterkunft in der Roemerstrasse wieder ans Netz bekommen. Dem dort wohnenden Vorsitzenden des „Menschlichkeit“-Vereins hatte ich schon vor einigen Wochen zwei Freifunk-Router vorbeigebracht – dann lief aber sein Internetvertrag aus, und seither sitzen die Leute dort wieder auf dem Trockenen. Sollte die Unterkunftsleitung mitmachen und wir noch einmal Spenden an den Verein zusammenbekommen, koennte aber Nitek eventuell eine Richtfunkstrecke aufbauen – vom Eselsberg auf den Kuhberg, ueber 3,7 Kilometer ueber das Blautal hinweg 😀

Vier Wochenenden voller Open Data

Es gibt ja so Veranstaltungen, nach denen geht man voller Motivation nach Hause. Bei mir sind es gerade fuenf Open-Data-Veranstaltungen in fuenf verschiedenen Staedten an den letzten vier Wochenenden gewesen, und sollte jetzt noch irgendwas kommen fallen mir vermutlich vor lauter Grinsen die Ohren ab.

Aber der Reihe nach.

Berlin: Bahn, die erste

IMG_1104

Beste Aussichten hatte am ersten Märzwochenende der Workshop, den die OKF fuer die DB Station&Service in Berlin ausrichtete – buchstaeblich wie metaphorisch. Die Station&Service moechte naemlich sich und ihre Daten oeffnen, wie das die SNCF in Frankreich bereits getan hatte. Die Personenzusammensetzung war genau richtig, und ich am Ende ganz schoen geschlaucht vom Brainstormen und reden. Ich bin sehr gespannt, wie es hier weitergeht, und hatte mir den gesamten Abend danach und die Heimfahrt noch ueberlegt, welche Community-Teile zum Beispiel aus der OpenStreetMap sich hier noch verknuepfen lassen.

Freiburg: Hackathon unterm Sternenbanner

Ganz ohne Getoese hat sich auch Freiburg einen festen Platz auf der Landkarte der innovationsbereiten Staedte verschafft. Das liegt auch an Ivan Acimovic, der in seiner Stadtverwaltung auf ueberraschend viele Open-Data-Vorantreiber_innen bauen kann – und gleich mit einer halben Armee von Mitstreiter_innen einen Open-Data-Hackathon im Carl-Schurz-Haus aus dem Boden stampfte.

Begrüßung durch Friederike Schulte und Katja Schwab zum #opendata #hackathon pic.x.com/a5k2k3etjb

Mit der Stadt alleine war es naemlich nicht getan – bwcon Suedwest, das Carl-Schurz-Haus und Profs der Hochschulen Offenburg und Furtwangen warfen sich mit ins Zeug, um diese Veranstaltung durchzufuehren. Dass alle Ergebnisse im Rathaus ausgestellt werden, ist da nur konsequent.

Teams working pic.x.com/pznegef9wu

Diskussionen und networking pic.x.com/pkj6k8ctcd

Neben den zu erwartenden Wiederkehrern auf allen Open-Data-Hackathons (natuerlich gab es eine neu erfundene Issue-Tracking-App, die nicht bestehende Loesungen wie Mark-A-Spot verwendet :D) stach fuer mich „Frieda“ besonders hervor: Eine benutzerfreundlichere Neuinterpretation des Freiburger Datenportals FR.ITZ, das bei der Usability noch… Potenzial hat.

Frieda die kleine Tochter von Fritz pic.x.com/uwnpmluei7

Ein wenig schade, dass dieses Projekt bei der Preisvergabe nicht mehr gewuerdigt wurde – zusammen mit dem Projekt „Data Canvas“, das Datenangebot und Bedarfe anhand von Problemstellungen analysieren wollte, haette ich „Frieda“ deutlich hoeher gerankt. Ich bin gespannt, wie viele der Projekte noch weiter entwickelt werden – und wie viele der enthusiastischen Teilnehmer_innen beim kommenden OK Lab Freiburg zu sehen sein werden, das ich leider ganz alleine vertreten musste 🙂

Frankfurt: Die Bahn bewegt (sich) doch!

Und eine Woche spaeter verstummten die Voegel, und der Mond verdunkelte die Sonne, und das scheinbar undenkbare geschah: Die Deutsche Bahn lud zu einem Datenhackathon!

Gerade mal zwei Wochen vorher hatte ich ueberhaupt davon erfahren – ironischerweise auf dem Rueckweg vom DB-Workshop in Berlin, auf dem wir uns fragten, wann sich denn die DB Fernverkehr endlich bewegen wuerde. Der Hackathon war wohl binnen weniger Wochen auf die Beine gestellt worden und war fuer mich eine ausgezeichnete Gelegenheit, einmal mit den Leuten im Konzern zu sprechen, die gerne viel mehr Daten freigeben wuerden – die aber nicht einfach machen duerfen, wie sie gerne wuerden.

Großartiger #DBHackathon war großartig! pic.x.com/lw7sktgnt5

In gigantischer 1970er-Jahre-James-Bond–Superschurken-Hauptquartier-Atmosphaere hackten immerhin rund 50 Teilnehmer_innen an den noch-nicht-wirklich-offenen Daten der Bahn – Daten, an die in einigen Faellen wohl bislang selbst die Bahn-Leute konzernintern noch nie herangekommen waren, und die es nur durch diesen Hackathon erstmals aus ihrem jeweiligen Silo herausgeschafft haben. Ausgangszustand: Dass die Teilnehmer_innen „nur“ ein einseitiges NDA-Dokument unterzeichnen mussten, ist bereits ein grosser Fortschritt.

Kurios: Zwischen all den MacBooks hat sich gestern Abend spontan eine reine Thinkpad-Gruppe gefunden. #DBHackathon pic.x.com/h7tiixdulc

Pimp the Reiseauskunft der @DB_Bahn! #DBHackathon pic.x.com/cogtu0abqq

Ich musste leider noch am selben Abend weiter, um rechtzeitig nach Moers zu kommen, aber Falco aus der Ulmer Arbeitsgruppe hatte sich spontan mit drei anderen zusammengetan und mit seiner Gruppe mal eben eine bessererere™ Reiseauskunft gestrickt, die historische Verspaetungen beruecksichtigt und die Wahrscheinlichkeit angibt, einen bestimmten Anschluss zu erreichen. Hut ab! Mehr Eindruecke gibt es in einem Youtube-Video der Veranstalter.

Ich warte jetzt jedenfalls ganz gespannt, dass die Ergebnisse des Hackathons konzernintern durch die Entscheiderpositionen sickern – und hoffe instaendig, dass wir demnaechst einmal ein Transit-Camp auf die Beine stellen koennen, bei dem Vortraege, Austausch und Coding Hand in Hand gehen. Idealerweise mit einem Augenmerk auf moeglichst hohe Diversitaet – Fahrtkostenbezuschussungen und eine inklusivere Ansprache koennten viel dazu beitragen, nicht nur die ueblichen Verdaechtigen bzw. die Leute aus dem direkten Umland anzulocken 😉

Schade, dass das Geschlechterverhältnis beim #DBHackathon so sehr unausgeglichen ist. @DB_Bahn, wollt Ihr dagegen in Zukunft etwas machen?

Moers: Die heimliche Open-Data-Hauptstadt im Nirgendwo

Während @ulmerleben in FFM beim #DBHackathon codet, sind @gruenzeug und @_stk nun beim #ODDMO15 🙂 #ulmapiontour pic.x.com/l2i30bpv4c

Solcherlei Inklusivitaetsfoerderung war fuer Moers dagegen gar kein Problem – Dank Reisekostenbezuschussung waren „die Ulmer_innen“ gleich zu zweit beim dortigen Hackday, und auch aus Berlin kamen Abordnungen an den Niederrhein.

.@drewSaysGoVeg is talking about examples of OpenData #ODDMO15 pic.twitter.com/2JEqsEKGhV

— Elmar Burke (@elmarburke) March 21, 2015


Claus Arndt
tut sich schon seit einiger Zeit damit hervor, am Rande der Einoede zwischen Pott und den Niederlanden in seiner Kommune das Thema voranzubringen — und kann in seiner Position hierzu auch einiges bewegen. Zum Beispiel diesen Hackday zu veranstalten, bei dem sich auch gleich Interessierte aus dem gesamten Umland fanden, um auch gleich ueber eine Gruendung von „Code for Niederrhein“ nachzudenken.

Moers rockt! Vielen Dank an @OpenDataMoers, @derarndt & @nowanda1 für diesen tollen #ODDMO15! #opendata #ddj pic.x.com/4oncrghdwz

Moers zeigt fuer mich vor allem, dass Erfolg bei Open Data momentan weniger das Ergebnis grossangelegter Strategiepapiere ist, sondern vom Aufeinandertreffen einer aktiven Community auf engagierte Einzelpersonen mit Gestaltungsspielraum in der Verwaltung lebt. Die besten Absichtserklaerungen, die tollsten Forschungsprojekte nuetzen nichts, wenn die Verwaltung nicht dafuer sorgen kann, dass die freiwilligen Datenveredler ihren Spass nicht verlieren. Indem sie zum Beispiel die Rahmenbedingungen schafft, dass 1.) Daten reibungsarm beschafft werden und 2.) Ergebnisse reibungsarm den Weg zurueck in die Verwaltung finden koennen. In Moers klappt das.

Ausklang des ersten Tages bei @OpenDataMoers pic.twitter.com/gOUmW79GrD

— Madeleine Neumann (@Maggysche) March 21, 2015

Mehr nachzulesen gibt es auf Wegweiser-Kommune [2], im Government-2.0-Netzwerk, bei Habbel, und in einem Flickr-Fotoset von @mrtopf. Und im Blog von Anke Knopp wird auch erklaert, was es mit der Feuerwehr auf sich hatte 😉

Die Moerser Feuerwehr beteiligt sich mit dem Projekt OpenAufzug am #oddmo15. „Kein Ding, wir war’n mal Bergleute!“ pic.x.com/uuzoxdjrxi

Im Video klingt es auch ein wenig an: Neben Redeployment-Auslotung hatten Juka und ich auch inhaltlich was gemacht, Verkehrszaehlungsdatenauswertung naemlich. Dazu kommt aber noch spaeter mehr 🙂

Leipzig: Code for Germany meets again

Etwas ueber ein Jahr nach dem Auftakt von Code for Germany waren Rens und ich zum gemeinsamen Workshop in Leipzig — um eine grossartig gewachsene Familie von OK Labs zu treffen, die sich mittlerweile auf verschiedenste Themengebiete verteilt hat, von Spielplatzkarten bis zu Feinstaubsensoren fuer jede_n zum Selbst-aufstellen.

Fun, fun, fun. @codeforde doing a spectogram at their national workshop pic.twitter.com/6mxaMQS1l8

— drew on the web (@drewSaysGoVeg) March 28, 2015

Dementsprechend werden mittlerweile auch die Herausforderungen umfangreicher. Ging es anfangs um die Vernetzung an sich, Sichtbarkeit und Austausch, geraten wir als Gemeinschaft nun an die etwas knackigeren Probleme — offenbar genauso, wie das schon beim Vorbild Code for America der Fall war. Redeploying, also das Ausrollen bereits anderswo erprobter Loesungen mit den Daten der eigenen Kommune, scheitert allzu haeufig an der Vielfalt der Datenformate, die aus den Fachverfahren fallen, Standardisierung ist weit weit weg, und akademische Ideen wie die Semantifizierung aller Daten sind momentan leider noch wenig praxistauglich. Zudem sind vielfach Interessierte zu einem Thema bei sich eher alleine, und andere Interessierte anderswo muessen erst einmal gefunden werden.

Replying to @codeforde @codeforde Award 2015 für @UlmAPI und Jena #codeforde pic.x.com/twxhs1dgyc

Umso dankbarer bin ich mittlerweile fuer die verbindende Klammer, die CfG mittlerweile bildet, und bin gespannt auf das, was da noch kommt. Ich bin unglaublich froh darueber, dass schon sehr frueh Diskussionen ueber einen Code of Conduct begonnen hatten — aus Fehlern anderer lernen, ganz angewandt. Und ich moechte mal ganz ausdruecklich ein Dankeschoen an Fiona und Julia aussprechen, die sich nun ueber ein Jahr lang um Vernetzung, Bereitstellung passender Werkzeuge, und das Ruehren der Werbetrommel gekuemmert haben.

Auf das naechste Jahr! Und noch viele kommende Open-Data-Wochenenden 😉

Mission-Statement-Puzzle #crowdsourcing pic.x.com/h81zdql8sm

Civic Issue Tracking mit Mark-A-Spot

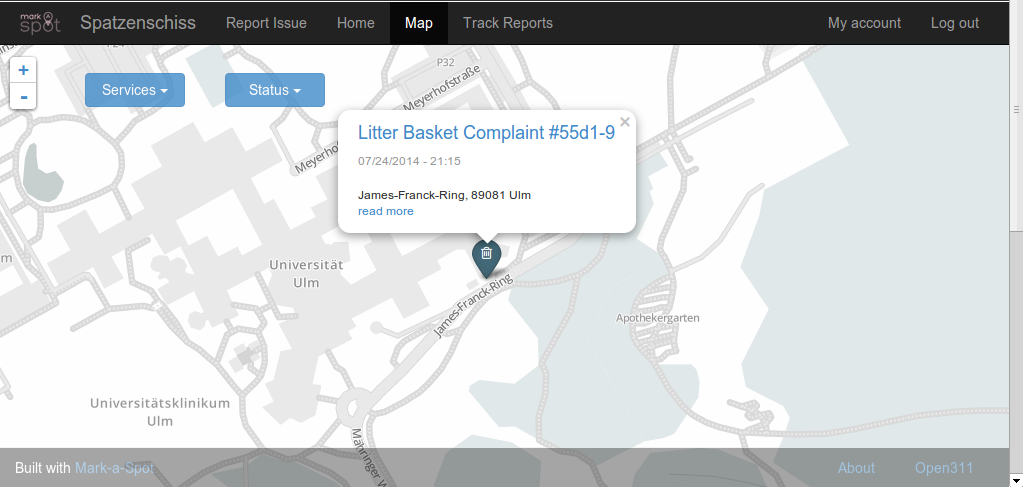
@ManuelBogner von der SWP machte die datalove-Gruppe vor gut zwei Wochen auf eine Anwendung der SZ aufmerksam, in der Unfallschwerpunkte markiert werden koennen – und die dafuer verwendete Drupal-Distribution Mark-A-Spot. Die kann beliebige Eingaben verwalten (z.B. uebervolle Muelleimer, kaputte Strassenlaternen oder aehnliches), die entgegennehmende Stelle kann den Status der Eingabe aktualisieren (von „in Bearbeitung“ bis „wurde abgearbeitet“), und das Ganze ist dann auch noch mit dem Open311-Standard kompatibel.

markaspot

Weil ich mir das mal ansehen wollte, habe ich mir das mal testweise auf meinem Raspberry Pi installiert – und weil es dabei einige Fallstricke gab, ist das hier kurz dokumentiert.

Exkurs: Ich habe fuer solche RasPi-Spielereien ein Minimal-Image auf einer 1-GB-SD-Karte (bitte dortige Installations- und Konfigurationsanleitung beachten). Das reicht locker aus; gegebenenfalls muss zwischendurch der apt-Cache mit apt-get clean geleert werden. Fuer die hier gezeigte Installation sind folgende zusaetzlichen Pakete noetig: apache2 apache2-utils libapache2-mod-php5 php5 php5-sqlite php5-common php5-cgi php5-gd unzip

Mark-A-Spot wird als komplette Distribution ausgeliefert, d.h. im aktuellen Master-Branch von Github liegt ein komplettes Drupal samt aller Erweiterungen, um eine lauffaehige Mark-A-Spot-Instanz zu bauen. Analog zum Installationsvideo laeuft die Installation folgendermassen:

Mark-a-Spot Open311 Server from Holger Kreis on Vimeo.

cd /var/www
wget https://github.com/markaspot/mark-a-spot/archive/master.zip
unzip master.zip
mv mark-a-spot-master/* .
rm master.zip

Wie in der Drupal-Anleitung angegeben muessen fuer die Installation noch einige Rechte gesetzt werden:

chmod a+w sites/default
cp sites/default/default.settings.php sites/default/settings.php
chmod a+w sites/default/settings.php

Da der RasPi fuer so eine Installation eine verdammt untermotorisierte Maschine ist, muss noch der Speicher fuer PHP und die maximale Scriptausfuehrungszeit hochgesetzt werden, sonst wird der Installer mit einem AJAX-Fehler 400 abbrechen:

nano /etc/php5/apache2/php.ini

service apache2 restart

Danach wird einfach der RasPi im Browser aufgerufen und der Installationsprozess so wie im Video vervollstaendigt. Dauert etwa eine halbe Stunde (ja, das Ding ist zu langsam dafuer…)

Danach sollte die Seite an sich laufen – bis auf vielleicht den Seiteneffekt, dass keine der Unterseiten laedt, sondern einen 404 liefert. Das liegt in der Regel an den Clean URLs; in der Installationsbeschreibung wird das en passant erwaehnt:

Make sure that clean urls are supported and active: http://yourserver/?q=admin/config/search/clean-urls

Falls Clean URLs nicht funktionieren, kann man die also dort abstellen (einfach den Haken wegmachen) – oder aber analog zu dieser Anleitung den Apache konfigurieren:

a2enmod rewrite
service apache2 restart
nano /etc/apache2/sites-enabled/000-default

Bleibt zuletzt nur noch, wie im Initial Configuration-Abschnitt angegeben, die Startpositionen und Karteneinstellungen anzupassen.

Hope this helps 😉

Zu Businesskasperei und Open Data

IMG_9820-09820-20140716

Vergangenes Wochenende war ich bei Workshops von Code for Germany und Code for All; am Montag startete Code for Germany offiziell; und danach war OKFest in Berlin.
Anlaesslich dieser Veranstaltung wurden Dinge gesagt, getan und geschrieben, die ich nicht unkommentiert stehen lassen moechte.

Erstens.

Ich halte die Initiative „Code for Germany“ fuer wertvoll, auch wenn ich den Namen nicht mag. Wir in Ulm coden nicht „fuer Germany“ und wir coden eigentlich auch nur deswegen „fuer Ulm“, weil wir zufaellig dort wohnen und das das naheliegendste Einsatzgebiet ist.

Der Witz an der Sache ist meines Erachtens genau nicht nur „fuer Ulm“ oder „fuer Germany“ zu entwickeln, sondern die Ideen anderer ueberhaupt erst zu entdecken und auf die eigene Situation anpassen zu koennen – und dass Ideen aus der eigenen Stadt anderswo aufgegriffen werden. Oder dass wir fuer die Ulmer Kita-Karte nun auf einen Kartendienst aus dem Berliner Lab zurueckgreifen konnten (danke, Jochen!)

Und nicht zuletzt habe ich es als unglaublich motivierend empfunden, festzustellen, dass es auch anderswo gleichgesinnte gibt, die fuer dieselben Dinge brennen. Vor allem nicht nur in Berlin.

IMG_1062

Zweitens.

Ich konnte mich schon auf der Launchveranstaltung nicht beherrschen und habe Seitenhiebe auf einen vorangegangenen Redner abgefeuert, der den Hauptvorteil offener Daten darin zu sehen schien, Geschaeftsmodelle zu entwickeln, um die von ihm zitierten 33 Millionen EUR Wert pro Jahr aus den Berliner Daten abzuschoepfen. Wir bei der datalove-Gruppe haben kein Geschaeftsmodell. Wir haben das bislang gemacht, weil es Spass macht, weil wir Probleme loesen und die Welt zu einem besseren Ort machen wollen.

Dass das in die klassische kapitalistische Logik nicht so recht passen will, ist bedauerlich. Den Ausweg sehe ich aber nicht darin, immer noch mehr Startup-Ideen anzukurbeln und aus der Herzenssache einen Brotjob zu machen zu versuchen – und ja, auch ich bin dem Google-Sponsoring fuer codefor.de gegenueber skeptisch, auch wenn ich gerade deutlich zu nuechtern bin, das so auszudruecken wie Stefan Schulz in der FAZ.

Ich fand es aufschlussreich, wie viele der anderen Workshopteilnehmer_innen mir am Wochenende zustimmten, dass der Traum doch eine 20–30h-Woche in einem schoenen Beruf waere, der fuer Wohnung, Essen und Mobilitaet sorgt – und die restliche Freizeit kann dann mit Weltverbesserung gefuellt werden.
Dass so etwas in der Praxis nur einer kleinen Elite vergoennt ist, ist mir schmerzlich bewusst. Aber wenigstens liesse man sich auf diese Tour weder so einfach zum “useful idiot”¹ machen, noch muesste man irgendwelchen Investorengeiern hinterherlaufen. Sondern koennte wirklich an dieser Weltverbesserung arbeiten.

IMG_1063

Weswegen. Drittens.

Ich gerne die Gruppe vorwiegend weisser, maennlicher Informatiker, die zumindest das Ulmer Lab momentan praegen, stark erweitern wuerde – mit der bestehenden Gruppe als Kristallisationspunkt, um den herum neue, interessante Dinge entstehen.

Das Laboradorio Para La Ciudad ist ein herrliches Beispiel dafuer, wie das aussehen kann: Im Vordergrund steht der Lebensraum Stadt und die Menschen, die ihn bewohnen, und sie sind es auch, die ihre alltaeglichen Probleme am besten kennen. Im Idealfall steht hinter allen Projekten auch das Ziel, die BewohnerInnen selbst zur Umsetzung der Loesungen zu ermaechtigen – Code Literacy als Auftrag, angefangen von SchuelerInnen bis ins dritte Lebensalter.

Das wuerde erstens helfen, dass nicht wie bisher alle Projekte auf den Schultern immer derselben wenigen Aktiven ruhen; zweitens deutlich vielfaeltigere Problemlagen erschliessen; und drittens einem deutlich groesseren und breiteren Bevoelkerungsquerschnitt den Zugang zu moeglichen Loesungen verschaffen.

Claus Arndt hat bei sich in Moers bereits ein Schulprojekt angestossen, dessen bisherige Ergebnisse sich spannend anhoeren – so etwas koennte beispielsweise auch in die Ulmer Drei-Generationen-Universitaet passen.

Dahinter wird in den seltensten Faellen ein Business Modell zu finden sein. Aber wenn’s zur Weltverbesserung reicht, waere mir das gut genug.

¹ ich stimme an der Stelle zum vermutlich ersten Mal in meinem Leben Evgeny Morozov zu 🙁