Wenn man (aus welchen Gruenden auch immer) wissen wollte, wo in der Gegend Sparkassen nahe an Tiefgaragen liegen, dann liegt es natuerlich sehr nahe, auszurufen „aha, das ist ein Fall fuer Open Data!“ und damit auch gleich ziemlich richtig zu liegen.
Aber Moment mal: Das filtert doch nach allen in OpenStreetMap verzeichneten Banken, nicht nur nach Sparkassen! Ja, richtig – in der Zeile obendrueber ist ein Filter, der nur die Banken beruecksichtigt, die „Sparkasse“ heissen. Aber der beruecksichtigt eben nur Banken, die exakt Sparkasse in genau dieser Schreibweise heissen.
Manche Sparkassenfilialen sind in OpenStreetMap auch einfach nur als Sparkasse getaggt, andere heissen so wie die jeweilige Kreis- oder Stadt- oder sonstige Sparkasse. Ob name = Sparkasse Neu-Ulm - Illertissen (Brückenhaus) schon zu ausfuehrlich ist, mag ich nicht beurteilen. Wenn man alle Banken sucht, in deren name Sparkasse vorkommt, koennte man die Abfrage mit einem Regulaeren Ausdruck bauen, beispielsweise mit einer Suche nach nwr["amenity"="bank"][name~".*(S|s)parkasse.*"]. Das Problem dabei: Solch eine Anfrage an die Overpass-API laeuft schnell in einen Timeout, sobald der abzufragende Kartenausschnitt etwas groesser ist.
Der Unterschied zwischen Namen, Betreiber und Marke
Beim Blick auf den Screenshot oben mit der Filiale am Brueckenhaus faellt aber der Key operator= auf, in dem hier explizit die Sparkasse Neu-Ulm – Illertissen (mit exakt diesem etwas seltsam aussehenden Namen) als Betreiberin eingetragen war. Und wenn man das Tagging-Schema fuer Banken genauer betrachtet, wird dort der Key brand= vorgeschlagen, mit dem die „Marke“ einer Einrichtung angegeben werden kann.
Das vereinfacht die Suche nach bestimmten Banken, ohne irgendwelche Wildcard-Suchen auf den Namen machen zu muessen – wenn die Bank denn ausfuehrlich getaggt worden ist:
name bezeichnet den Eigennamen genau dieser Bankfiliale. Vielleicht reicht hier eh nur „Sparkasse“, andere schreiben sonst noch was dazu, so ist das eben in OSM.
operator ist die Betreiberin – hier eben die jeweilige oeffentlich-rechtliche Sparkasse mit ihrem Kreis- oder Stadt- oder sonstigen Namen
brand ist die (Dach)Marke der Bank – und das ist hier tatsaechlich immer „Sparkasse“
Ist „Aldi Sued“ dasselbe wie „ALDI SÜD“?
Alles erledigt, jetzt koennen wir filtern, wuerde man meinen – oder? Die deutschsprachige Beschreibung von brand weist aber darauf hin, dass der Markenname gemaess der jeweiligen Namenskonventionen eingetragen werden soll. Als Beispiel: Aldi-Supermaerkte werden im Name-Tag als „Aldi“ oder „Aldi Nord“ oder „Aldi Sued“ getaggt. Die Schreibweise der Marke sei jedoch „ALDI Nord“ oder „ALDI SÜD“. Das muss man natuerlich dann erst einmal wissen, sowohl beim Tagging als auch bei der Abfrage.
Mit Linked Open Data ist aber auch dieser Fallstrick ueberhaupt kein Problem mehr, und sowohl die Wiki-Beschreibungen von brand als auch von operator verweisen jeweils auf die optionalen Keys operator:wikidata und brand:wikidata, mit denen beiden die eindeutige Wikidata-ID zugewiesen werden kann. Fuer eine Sparkassenfiliale kommt also neben brand=Sparkasse einfach brand:wikidata=Q13601825 dazu. Und schon lassen sich tatsaechlich nur Sparkassen anzeigen, die nahe an Tiefgaragen liegen – sofern denn brand und wikidata-ID der Marke getaggt wurden:
(Randbemerkung, weil ich die letzten Stunden Wikidata-IDs und operators und brands auf OpenStreetMap nachgetragen habe: Fuer Sparkassen ist das schoen aufdroeselbar. Bei Genossenschaftsbanken, die mal als „Volksbank“, mal als „Raiffeisenbank“ firmieren und fuer die es keine Wikidata-ID fuer die jeweilige „Marke“ zu geben scheint, wird das schon wieder komplexer. Ein neues Rabbit Hole!)
Ich habe mittlerweile ein kleines Hobby daraus gemacht, Abfragen zusammenzustellen, die Wikidata beantworten kann, bei denen ein Sprachmodell aber regelmaessig auf die Nase faellt.
Im Februar kam beispielsweise auf Mastodon die Frage auf, wie haeufig eigentlich welche Gaeste – und vor allem von welcher Partei – in den politischen Talkshows im Fernsehen eingeladen werden. Ein anekdotischer Kurz-Ausschnitt von Bluesky wirkte so, als gebe es da eine Tendenz. Aber viel besser als Anekdoten und Tendenzen ist natuerlich, der Sache datengetrieben auf den Grund zu gehen.
Ganz schnell kam in dem Thread auch jemand auf eine SPARQL-Abfrage, die mit Hilfe von Spinach erstellt wurde: Wie haeufig wurden Menschen einer gewissen Parteizugehoerigkeit zu Markus Lanz, Staffel 17 eingeladen. Die Abfrage ist schon nicht ganz verkehrt, nur tauchen da auch noch Kommunistischer Bund, SED und PDS auf – denn PolitikerInnen koennen im Lauf der Zeit nacheinander mehrere Parteizugehoerigkeiten haben. Sarah Wagenknecht wuerde hier beispielsweise fuer mehrere Parteien zaehlen, auch wenn sie „nur“ als Vertreterin des nach ihr benannten Buendnis eingeladen war.
Ich hatte mich vor allem fuer Markus Lanz interessiert, deren Presseseite abgegrast um die Sendedaten und Gaeste in eine verarbeitbare Form umzuwandeln, und mich dann nach langer Zeit einmal wieder mit OpenRefine beschaeftigt, um daraus am Rande von Mit Wikipedia unterwegs in Neu-Ulm alles vorzubereiten, um fehlende Lanz-Episoden in Wikidata nachzutragen.
Das Schoene dabei ist: Viele der Talkshowgaeste sind „Dauerbrenner“ – es ist sehr selten, dass jemand zum allerersten Mal in einer der Shows landet. Hier mal jemand von der BundesschuelerInnen-Vertretung, dort mal jemand aus der Wirtschaft, das ist sehr ueberschaubarer haendischer Aufwand, fuer diese fehlenden Personen ein zugehoeriges Wikidata-Objekt anzulegen.
Und weil Menschen wie Raimond Spekking mit beeindruckender Ausdauer Menschen und Dinge fuer Wikimedia Commons fotografieren, ist es gar nicht so unwahrscheinlich, dass eine Person in Koeln bei der Aufzeichnung von „Hart aber Fair“ Raimond vor die Linse gelaufen ist – und dann gibt es auch ein passendes Foto dazu.
Diese Liste ist immer noch nicht perfekt. Zwar wird nur die Parteizugehoerigkeit ausgegeben, die kein Enddatum hat und es wird bei mehreren Eintraegen die mit einem Preferred Rank bevorzugt. Ex-Linken-MdB tauchen nur mehr mit ihrer aktuellen Partei auf – ganz unten kommt einem aber Juergen Trittin zweimal des Weges, bei dem auch noch die Mitgliedschaft im Kommunistischen Bund auf Wikidata verzeichnet ist – ohne Enddatum. Das koennte man ohne weiteres Zutun auch noch eingrenzen, indem nur Parteien gewertet werden, die noch existieren, also kein Aufloesungsdatum in ihrem Datenobjekt haben. Oder bei Herrn Trittin die Mitgliedschaft bei den Gruenen als Preferred Rank setzen. „Schoener“ faende ich es natuerlich, wenn dort aber auch ein Enddatum zur Mitgliedschaft stuende – dafuer fehlt mir aber leider eine einsehbare Quelle.
Drei Dinge an diesem Ansatz finde ich so schoen, dass das einfach in die Rubrik „Schoener Leben mit Linked Data“ gehoert:
1.: Linked (Open) Data ist mehr als die Summe der einzelnen Teile!
Ich konnte bei der Vervollstaendigung dieser Abfrage auf unglaublich viel Vorarbeit anderer zurueckgreifen. Angefangen vom Modellierungsschema, aber vor allem auch die Vor-Arbeit bei den Datenobjekten der jeweiligen Personen, die bereits die Parteizugehoerigkeit und viele weitere Eigenschaften mitbringen.
Ich kann so etwas natuerlich immer auch von Hand machen: Eine Liste anlegen, in der ich Personen Parteien zuordne, und dann laeuft das fuer meine Auswertung. Aber nur dort. Und wenn jemand mal die Partei wechselt, muss ich das entsprechend anpassen. Oder, noch schlimmer, Faelle abfangen, in denen jemand im Zeitraum X zu einer Partei gehoert, im Zeitraum Y zu einer anderen. Und damit kommen wir zum zweiten schoenen Punkt:
2.: Jeder Beitrag zu Linked (Open) Data staerkt das Gesamtsystem – selbst dann, wenn ich irgendwann keine Lust mehr habe!
Als ich Talkshowfolgen nachgetragen habe, wollte ich damit eine Auswertung ueber Parteizugehoerigkeiten machen. Da aber die Personen-Datenobjekte viele weitere Eigenschaften maschinenauswertbar mitbringen, habe ich damit die Moeglichkeit zur Beantwortung vieler weiterer Fragestellungen geschaffen. Wer moechte, kann nun auch Statistiken ueber das Alter der Eingeladenen erstellen. Oder ueber das Geschlechterverhaeltnis. Oder zu sonstigen Fragestellungen, die mal auftauchen koennten.
Und da dieses Projekt nicht in einem git-Repo von mir herumliegt, ist es auch sehr viel einfacher fuer die tausenden Mitwirkenden z.B. bei Wikidata, ganz im Vorbeigehen dafuer zu sorgen, dass diese Informationen aktuell bleiben. Egal ob Parteizugehoerigkeit, das Nachtragen weiterer Folgen, das haengt alles nicht mehr alleine von mir ab, oder davon, dass ich einen Pull-Request fuer mein Projekt annehme.
Und schon die aktive Nutzung dieser Informationen sorgt fuer Qualitaetskontrolle im Vorbeigehen. Gerade solche Punkte wie die angeblich noch bestehende Mitgliedschaft von Juergen Trittin wird bei so einer Nutzung offenkundig – und kann nun direkt im Datenbestand korrigiert werden (wenn man denn die dafuer notwendige Sekundaerquelle findet).
3.: Versuch das mal mit ’nem Sprachmodell
Die Standarderwiderung gerade ist ja, dass man das doch sicher auch per LLM machen koenne. Und ich lade herzlich dazu ein, das mal zu versuchen und dann davon zu berichten 😀
Denn, die Besonderheit bei diesen Auswertungen: Die sind meist in dieser Granularitaet bislang von sonst niemandem gemacht worden. Das heisst, sie liegen nicht als fertige Liste im Web vor. Das heisst, ein Sprachmodell findet die nicht, um sie per RAG in seine Ausgabe zu konfabulieren. All-Time-Spitzenlisten fuer alle Polittalkshows gibt es im Web (auch dort an der Spitze: Elmar Thevessen). Aber nicht fuer einzelne Talkshows, oder fuer einen bestimmten, frei waehlbaren Zeitraum.
Das heisst andersherum auch: Je mehr Wissen der Welt wir als semantische Daten in einem Wissensgraphen erfassen, desto mehr dieses Wissens koennen wir auch verlaesslich, deterministisch und mit im Vergleich zu einem LLM laecherlichen Energieaufwand abrufen. Die Antwort wird nicht immer perfekt sein. Aber dann lassen sich die Fehler und Unvollstaendigkeiten in den Ausgangsdaten transparent und nachvollziehbar korrigieren.
Ein cooler Schritt in die Richtung, der das Nachtragen nicht nur von Talkshowfolgen erleichtern wuerde, waere zum Beispiel, wenn der oeffentlich-rechtliche Rundfunk die Informationen ueber solche Sendungen gleich in einem semantischen Format ausgeben wuerde. Bonus fuer die Verlinkung der Wikidata-Datenobjekte oder andere Identifier der Gaeste. Aber schon der erste Schritt waere schon gigantisch 🙂
Eines meiner Lieblingsbeispiele, wenn ich ueber Linked Open Data spreche, sind Strassennamen. Das klingt auf den ersten Blick weit hergeholt, aber wer jemals groessere Mengen an Adressen mit einem Computer verarbeiten wollte, ist vermutlich irgendwann ueber die Liste der Falsehoods programmers believe about addresses gestolpert.
Die Quadrate in Mannheim (anstatt Strassennamen) sind dabei eher die Ausnahme. Dass in einer Gemeinde – in der Regel nach Eingemeindungen – mehrere Straßen mit demselben Namen existieren, oder dass in einer Ortschaft gar keine Strassennamen vergeben wurden, kommt dagegen relativ haeufig vor. Hilgermissen als Gemeinde mit 2200 BewohnerInnen, aber keinem einzigen Strassennamen, ist angesichts seiner Groesse so besonders, dass das DLF Nova einen Rundfunkbeitrag wert war. Neben Hilgermissen gibt es aber viele weitere kleine Oertchen, in denen die Haeuser einfach nur eine Hausnummer haben. Und egal, ob es einen Strassennamen gibt oder nicht: Sobald Menschen eine Adresse in irgendein Computersystem eingeben, wird es schnell haarig und fehlerhaft.
Adlitz: Schilder in die naechsten Staedte, aber keine Strassenschilder. Roehrensee, CC BY-SA 4.0, via Wikimedia Commons
Bei den Ortschaften ohne Strassennamen liegt das meist am Verwirrungsfaktor. Wir haben uns so sehr daran gewoehnt, dass eine Adresse aus Strasse, Hausnummer, Postleitzahl und Ortschaft liegt, dass es sich falsch anfuehlen wuerde, einfach nur „5, 95491 Adlitz“ zu schreiben – obwohl das eigentlich richtig waere. Vermutlich alle diese Doerfer ohne Strassennamen wurden spaetestens durch die Gebietsreformen in den 1960er- und 70er-Jahren der naechstgroesseren Gemeinde zugeschlagen und verwenden auch die Postleitzahl dieser (oder einer anderen) groesseren Gemeinde. Daher liegt es nahe, diese Adresse stattdessen „Adlitz 5, 95491 Ahorntal“ zu schreiben.
Auch wenn das fuer die Postzustellung oder fuer die eigene Orientierung keinen praktischen Unterschied macht – richtig ist das nicht, und bei der maschinellen Auswertung kann so etwas zu Problemen fuehren. (Dass es zwar eine Gemeinde Ahorntal gibt, aber gar keinen Ort, der so heisst, ist noch einmal eine ganz andere Geschichte, die hier aber keine grosse Rolle spielt).
Denn, wie auch bei gesprochener Sprache sind wir als Menschen ganz gut darin, Mehrdeutigkeiten oder unpraezise Ausdruecke einfach passend zum Kontext einzuordnen. Wir lesen nicht einfach nur, was irgendwo steht und interpretieren das nur buchstaeblich, sondern wir interpretieren ohne gross darueber nachdenken zu muessen, was gemeint gewesen sein koennte. Aber bloederweise gehen wir andersherum auch beim Schreiben davon aus, dass ein Gegenueber schon wissen wird, was eigentlich gemeint ist. Und dass dieses Gegenueber nicht etwa ein Computer ist, der das Geschriebene vergleichsweise woertlich auslegt. Und dann wird’s wild.
Ganz offizielles Strassenschild – der Platz heisst aber offiziell „Augsburger-Tor-Platz“! Foto: -stk, CC BY-SA 4.0, via Wikimedia Commons
Zuletzt bin ich darueber gestolpert, als WikipedianerInnen aus dem WikiMUC und dem temporaerhausgemeinsam bei einem Editathon die tausenden Feuerwehren in Bayern in Wikidata einpflegen wollten. Der Landesfeuerwehrverband hat eine Liste aller bayerischen Feuerwehren auf seiner Website, und die wird ganz offensichtlich von Menschen gepflegt, mit der Schreibweise der Adressen, die sie gewohnt sind. Mal wird im Strassen-Feld der Name des Ortsteils dem Strassennamen vorangestellt („Schwaighausen, Unterharter Straße 3“), mal steht im Gemeinde-Feld eine Kombi aus Ortsteil und Gemeinde („Triefenstein OT Homburg“) oder aber irgendwann ist womoeglich beim Feuerwehrhaus das Hausnummernschild abgefallen und alle sind sich einig, dass die Hausnummer „neben HsNr. 7“ scho so basst. Das ist schliesslich eine Feuerwehr, die kann man selbst in einem kleinen Dorf mit nur einer Garage fuer den Tragkraftspritzenanhaenger nicht so einfach uebersehen. Meist ist da ja irgendwas an die Wand gemalt oder es ist eine E57 auf dem Dach, also bittschoen, das wird man ja wohl finden, und die Feuerwehrdienstleistenden brauchen eh keine Hausnummer, wenn die Sirene mal geht, damit sie zu ihrem Feuerwehrhaus kommen.
Wenn dazu noch inoffizielle Abkuerzungen und vielfaeltige Interpretationen von Getrennt- oder Zusammenschreibung kommen, wird es endgueltig wild. Das temporaerhaus hat eine Adresse in der „Augsburger Straße“ – allein in unserer Community wurden sehr lange verschiedenste Varianten von „Augsburger-Str.“ ueber „Augsburgerstr.“, jeweils dann mit Varianten mit scharfem s oder Doppel-S verwendet (bis ich das nicht mehr ausgehalten und darum gebeten habe, dass wir das alle so schreiben, wie es richtig™ ist, damit ich besser schlafen kann).
Meine These ist, dass selbst bei den Datenbestaenden innerhalb einer Stadtverwaltung je Strasse im Schnitt deutlich mehr als zwei Schreibweisen ueber alle Systeme hinweg existieren, und bislang konnte das noch niemand widerlegen. Oft ist nicht einmal auf allen Strassenschildern der richtige Name der Strasse angebracht. Die „falschen“ Schilder sind bisweilen erkennbar alte Exemplare, die moeglicherweise vor einer Vereinheitlichung der Schreibweise aufgehaengt wurden. Aber nicht nur „neue“ Strassenschilder stimmen nicht immer mit dem amtlichen Namen ueberein, auch in Liegenschaftsverzeichnissen, Excel-Listen und moeglicherweise auch Fachverfahren tummeln sich mit grosser Sicherheit verschiedene Schreibweisen derselben Strasse.
Das kann automatisierte Auswertungen… schwierig machen. Der Versuch, aus den Adressen der Feuerwehren ueber Nominatim Geokoordinaten zu ermitteln, lief bei beeindruckend vielen der Eintraege gegen die Wand. Und selbst wenn man in einer Kommunalverwaltung ueberhaupt gleichzeitigen Zugriff auf alle Speicherorte haette, wo Strassennamen vorkommen: Eine Suche „gib mir alle Informationen, die irgendwie mit der Sankt-Johannes-Baptist-Straße zusammenhaengen“ wird spaetestens mit einer so kreativen Abkuerzung wie „St.- Joh- Bapt.- Str.“ (man beachte die Leerzeichen!) herausfordernd.
Nicht nur bei alten Strassenschildern schleichen sich Falschschreibungen ein. Diese Strasse heisst korrekt „Warmwässerle“. Foto: Looniverse, CC BY-SA 4.0, via Wikimedia Commons
Mit dem Konzept von Linked Data koennte man das ganz anders umsetzen. Die Sankt-Johannes-Baptist-Straße koennte ein Datenobjekt mit dem URI ld.bayern.de/location/street/081513121337 haben. Die 081513121337koennte dabei eine hierarchische Bedeutung haben und dadurch Rueckschluesse auf Regierungsbezirk, Landkreis und Gemeinde geben – es koennte aber auch eine ganz beliebige, fortlaufende Nummer sein, so wie bei Wikidata. Und dieses Datenobjekt hat dann passende Eigenschaften – beispielsweise:
Ein Label mit dem Namen der Strasse. In mehrsprachigen Gebieten koennen das auch mehrere Label sein, mit maschinenlesbarer Bezeichnung, welche Sprache das jeweils ist
in welcher Verwaltungsgliederung es liegt – also z.B. die zugehoerige Gemeinde, mit einem Link zum Datenobjekt dieser Gemeinde. Moeglicherweise auch feiner granular mit Bezeichnung des genauen Ortsteils
weitere Identifier, z.B. die Nummer im Strassenverzeichnis der Gemeinde
moeglicherweise eine Auszeichnung, ob es sich um eine amtliche (gewidmete) Strasse mit offiziellem Strassennamen handelt, oder sowas wie den „Resis-Traktor-Weg“, den zwar alle so kennen und benutzen, den es aber „offiziell“ nicht gibt
Geoinformationen wie einen Linienzug, der die Strasse auf einer Karte definiert, oder einen Link auf ein solches Geofeature-Datenobjekt
die Information, nach wem oder was die Strasse benannt ist – zum Beispiel mit einem Link auf das Wikidata-Objekt
Solch eine Datenhaltung hat gleich in mehreren Aspekten grossen Charme. Die Idee ist, dass – egal wo in der Kommunalverwaltung ein Strassenname eingegeben werden soll – per Autovervollstaendigung anhand des Namens das passende Datenobjekt aus diesem Linked-Data-Strassenregister gesucht wird. Auf der „Bildschirmvorderseite“ und ueberall, wo es in Texten und Adressen in der Folge um diese Strasse geht, wird stets das Label, also der Strassenname angezeigt. Der ist dadurch immer auch der „richtige“, aber sonst aendert sich weiter nichts.
Bei der Speicherung wird aber immer der URI auf diese Strasse abgelegt. Und das heisst, dass viel verlaesslichere Datenabfragen moeglich sind: Ueber alle Dinge – Firmen, Gebaeude, Einrichtungen – in genau dieser Strasse. Ueber alle Strassen in einer Gemeinde. Oder auch – falls auch das passend codiert ist – ueber alle Strassen in einem bestimmten Ortsteil, ganz ohne Namenskonventionen, wie der Ortsteil anzugeben ist. Und wird einmal eine Strasse umbenannt, zum Beispiel, weil ein Namensgeber spaeter als unwuerdig befunden wird, muss nur im Linked-Data-Strassenverzeichnis das Label geaendert werden, und in kuerzester Zeit ist diese Aenderung einheitlich an allen Stellen vollzogen.
Hier sieht man dann auch die Magie verlinkter Datenbestaende in der Praxis. Denn weil die Datenobjekte der Personen, nach denen eine Strasse benannt wurde, meist auch weitere Informationen wie z.B. das Geschlecht angeben, laesst sich mit Linked Open Data auch ganz durchautomatisiert und ohne weiteres Zutun darstellen, wie eigentlich das Geschlechterverhaeltnis bei der Strassenbenennung ist – so wie auf dieser interaktiven Karte von Frankfurt. Vor beinahe 11 Jahren hatte unsere Open-Data-Ehrenamtsgruppe das noch mit viel Handarbeit machen muessen und die Karte war auch irgendwann tot und die Daten versauerten – der EqualStreetNames-Ansatz laesst sich mit wenig Handarbeit uebertragen, und die Datenpflege in Linked Open Data hilft am Ende allen auf der ganzen Welt, auch wenn das Kartenprojekt einmal untergehen sollte!
Noch nicht ganz fertig: Eine interaktive Karte zur Geschlechterverteilung bei der Strassenbenennung in Neu-Ulm
Letzte Woche war ich beruflich fuer einen Vortrag (Slides) auf der TRANSFORM-Konferenz in Bern, wo ich viele inspirierende Diskussionen ueber Linked Data fuehren konnte. In einem Gespraech mit einem beeindruckend tief in der Materie arbeitenden Menschen von der Schweizerischen Bundeskanzlei liess ich nebenher das Strassenbeispiel als praktische Anwendung von LOD mit Nutzen fuer die Verwaltung fallen. Und mein Gegenueber blickte mich ueberrascht an – ich weiss rueckblickend nicht, ob es verwundert oder gar mitleidig war – und sagte lapidar, dass es das in der Schweiz natuerlich bereits gebe.
Fuer jede einzelne Strasse.
Ich versuchte, nicht sogleich aufzuspringen und mich in den naechstgelegenen Fluss zu stuerzen, sondern liess mir zeigen, dass in der Tat, es fuer jede Strasse in der Schweiz ein Datenobjekt gibt, zum Beispiel fuer den Philosophenweg in Bern, samt der zugehoerigen Geometrie. Und falls das Verlangen fuer die Sache nach dem Fluss nicht nachlasse, faende ich natuerlich auch die Aare als Datenobjekte, wobei es sich hier zu meinem Wohl explizit um Badegewaesser handle.
Es faellt mir schwer, den Zustand meines Emotiotops in diesem Moment zu beschreiben. Aehnlich ging es mir spaeter, als ein Mitarbeiter der Statistik bei der Stadt Zuerich mich neugierig fragte, wie viele kommunale Statistikabteilungen in Deutschland denn in ihren Prozessen mit Linked Data arbeiten wuerden, so wie sie, ganz natuerlich.
Zack. Bumm. Geht einfach. Screenshot von https://geo.ld.admin.ch/sparql/
Ich habe dann versucht, ueber diesen mentalen Zustand hinwegzukommen, indem ich eine SPARQL-Abfrage gebaut habe, um mir die Geometrien aller 822 Strassen in Bern ausgeben zu lassen, was in rund einer Sekunde… einfach so ging. Alle Haltestellen in Bern bekommt man in 0,225 Sekunden. Auch einfach so. Ganz selbstverstaendlich. Und ganz nebenbei, wenn in der Schweiz Linked Open Data veroeffentlicht wird, folgt das – natuerlich – verbindlich dem URI-Schema *.ld.admin.ch/*. Und es sei auch alles dafuer technisch notwendige ausgerollt, damit das funktioniert und dauerhaft stabile URIs sicherstelle, wie sich das ja auch gehoert. Nicht etwa, dass sich irgendwie Namen und damit auch URIs von Ministerien aendern (wie das bis heute selbst in DCAT-AP.de geschieht!) und dann fuehren auf einmal sowohl Website-URLs wie auch URIs ins Nirvana. Also so, wie das heute in Deutschland immer noch gang und gaebe ist und woran auch ueberraschend viele Digital-Lobby-Organisationen ueberhaupt gar keinen Anstoss nehmen.
Waere das bei uns auch so ganz normal, koennte man mal eben im Vorbeigehen ganz viele andere Schmerzen einfach so loesen.
Auszug aus dem Strassenverzeichnis von 1954, das die Open-Data-Community im temporaerhaus freundlicherweise von der Stadt Neu-Ulm bekommen hatte – der Ist-Zustand besteht immer noch aus Texten, manchmal eben auch auf Schreibmaschine geschrieben. Weitergeholfen fuer die Ueberfuehrung in Linked Open Data hat das dennoch immens!
Wer datenjournalistisch Sachverhalte auf Karten darstellen moechte, kennt naemlich dieses Problem auch: Geographische Raumbezuege sind haeufig nur eben als textliche Beschreibungen zugaenglich. Egal ob es darum geht, Unfallschwerpunkte auf einer Karte darzustellen, wie Jan-Georg Plavec berichtet (LinkedIn), oder um regelmaessig wiederkehrende Aufgaben wie die Darstellung von Wahlergebnissen auf einer Karte: Oft gibt es die Voraussetzungen fuer solch eine Kartendarstellung gar nicht maschinenlesbar.
Der Zuschnitt der Wahlkreise bei einer Wahl ist dabei noch vergleichsweise einfach: Das ist eine Liste von Kommunen oder Stadtbezirken, und dafuer gibt es meistens irgendwelche Geoshapes, die sich dafuer halbwegs angenehm verwursten lassen (Beispiel: Die Liste der Stimmkreise in Bayern). Sobald es aber um die Wahl- bzw. Stimmbezirke innerhalb einer Gemeinde geht, kann es anstrenged werden. Die liegen naemlich viel zu oft immer noch nur als Listen der in ihnen befindlichen Strassen vor. Und selbst an diese Listen zu kommen, kann aufwaendig sein, wie diese Dokumentation bei der OpenStreetMap zeigt.
Hat nichts mit Stimmbezirken zu tun, aber erwaehnt nochmal die Hildegardstr.: In dieser Version des Neu-Ulmer Strassenverzeichnis von 1978 sind auch die vorherigen Strassennamen erkennbar. Nochmals vielen Dank an die Stadt Neu-Ulm!
Aus Sicht der Wahlbehoerde ist das auch nachvollziehbar. Denn von einer Kartendarstellung hat sie ja fuer die Aufstellung des Stimmverzeichnis erst einmal gar nichts: Wenn ihr die Liste der jedem Wahllokal zugehoerigen Strassen vorliegt, kann sie aus dem Meldeverzeichnis die jeweiligen Listen der Wahlberechtigten erstellen – fuer ihren Auftrag hat sie damit alle Informationen, die sie braucht. Wenn es eine geographische Darstellung der Wahlbezirke anhand der Strassenlisten gibt, ist das womoeglich nur ein Zusatzaufwand. Manchmal leistet man sich den, manchmal aber auch nicht. Und wenn es eine geographische Darstellung gibt, heisst das immer noch nicht, dass die dafuer notwendigen Daten auch z.B. von Datenjournalist*innen wiederverwendet werden koennen.
Bei der Recherche gefunden: Eine immerhin (geo)graphische Darstgellung der Wahlbezirke in Regensburg, im PDF der Wahlbezirke sortiert nach Strassennamen. Das Dokument ist mit LaTeX generiert und ich bin jetzt total neugierig, wie die das machen!
Waeren die Strassen aber Datenobjekte, mit verknuepfter Geometrie, waere in beide Richtungen vieles so viel einfacher. Fuer den Zuschnitt der Stimmbezirke waeren Neuordnungen quasi live moeglich: Mit Drag und Drop auf der Karte (und der nur verwaltungsintern zugaenglichen Linked-Data-Verknuepfung zu Meldedaten) liessen sich Neuzuschnitte und die Auswirkungen auf die Gesamtzahl der Wahlberechtigten ganz einfach simulieren – oder auch durch mathematische Optimierungsverfahren Vorschlaege machen. Und ist die Ausdehnung einmal festgelegt, waere es ueberhaupt kein Problem mehr, diesen Zuschnitten geographische Umringe zuzuordnen.
Wir muessten dafuer nur die Informationen aus der Textform in das Linked-Data-Prinzip ueberfuehren. Das ist keine Zauberei, sondern einfach nur Infrastrukturarbeit, fuer die es den notwendigen Sachverstand fuer IT-Architektur und Datenstrukturen braucht. Und die bereits auf mittlere Sicht allen Beteiligten beeindruckend viel Handarbeit sparen und Fehlerquellen vermeiden wuerde.
Die Videos des „Akkudoktor“ Andreas Schmitz rund um Klein-Photovoltaikanlagen sind in Teilen meines Bekanntenkreis lange Pflichtprogramm. Da nerdet sich jemand richtig tief ins Thema rein (und ist auch schon vom Fach), testet Geraete tiefer auf Herz und Nieren als so manchem Hersteller das lieb ist und macht das derweil, ohne dabei was verkaufen zu wollen – weil er an den damit verbundenen hoeheren Zielen interessiert ist.
Im oben eingebetteten Video teilt er gute und schlechte Erfahrungen im Umgang mit Herstellern und wie das normalerweise mit Influencern und Influencer-Agenturen so laeuft – und da fiel es mir wie Schuppen aus den Haaren, dass das in weiten Teilen auch Erwartungshaltung sowie Spannungsfeld zwischen zivilgesellschaftlichem Civic-Tech-Einsatz und Verwaltung – und insbesondere Smart City – widerspiegelt.
Als Gold-Standardfall nennt Schmitz, dass es nach einem von ihm gemeldeten Problem sofort eine Krisensitzung gab, die Entwicklungs-/Engineering-Abteilung einbezogen wurde, er offenbar auch direkten Draht dorthin bekam und er die naechsten Schritte dargelegt bekam, was nun zur Fehlerbehebung passieren wuerde. Das Negativbeispiel, das bei Influencermarketing normal sei: Man habe nur Kontakt zu einer Influenceragentur. Die hat gar keinen Durchgriff aufs Produkt und bezahlt einen im Zweifelsfall, dass man gefundene Probleme nicht an die grosse Glocke haengt und die Schnauze haelt.
Kommt bekannt vor? Mir schon. Mit dem spannenden Unterschied, dass es die Entwicklungs- und Engineering-Abteilung z.B. in der Smart City meist nie im eigenen Haus gibt. Und es dementsprechend diesen Feedback- und Lösungs-Cycle gar nicht geben kann. Weil quasi jeder Schmarrn von externen Dienstleistern entwickelt wird – die manchmal brauchbares Requirement Engineering vom oeffentlichen Auftraggeber bekommen. Meist aber nicht.
Bei mancher oeffentlichen Stelle wuerde ich mittlerweile aus der Erfahrung im Austausch mit den an der Sache interessierten zivilgesellschaftlichen Engineers (w/m/d) und der behoerdlich eingerichteten Digitalisierungsagentur mittlerweile auch sagen: Das ist mehr Influencer-Agentur denn an der langfristigen Entwicklung interessierte Einheit. Denn sie sind nicht nur von den zu entwickelnden Produkten und Infrastrukturen so weit weg wie die Influencer-Agentur. Sondern ihnen ist im schlimmsten Fall das langfristige ideelle Ziel weniger wichtig als die akute oeffentlichkeitswirksame Darstellung.
Vor dem Hintergrund bin ich gerade auch etwas professionell angepisst vom neuerlichen Vorstoss der Social Entrepreneurs von ProjectTogether, die heute ihr neues rework-Programm vorstellten, mit dem nun alles bei der Verwaltungsdigitalisierung besser werden soll. Nicht nur, dass mir das gesamte Social-Entrepreneur-Wesen von Grund auf unsympathisch ist – ich halte diese Verlagerung von Verantwortung in Startups fuer Teil des Problems, nicht der Loesung. Dazu kommt, dass die Truppe mir mit UpdateDeutschland noch enorm schlecht in Erinnerung ist. Nach dem Event gab es einen Austausch mit Aktiven des Netzwerks Code for Germany, bei dem in kurzer Zeit immer deutlicher wurde, dass der ganzen Veranstaltung kaum vorbereitende Recherche vorausgegangen war, was es bislang schon gab und was weswegen (nicht) funktioniert hatte.
Ich persoenlich haette schon gerne, dass das mit der Verwaltungsmodernisierung was wird. Wenn dann brauchen wir aber mehr Austausch wie den, den Andreas Schmitz beschreibt. Und in vielen Faellen muss dafuer erst einmal die Entwicklungs- und Engineering-Abteilung im Staat erst mal wieder internalisiert und als wichtig eingeordnet werden, anstatt das weiterhin auf Dienstleister auszulagern. Einfach nur dasselbe Silicon-Valley-Cosplay weiter nachzumachen, wird lediglich auch in Deutschland laengst (mehrfach) abgespielte Playbooks nochmal von vorne auffuehren. Dabei den naechsten Schwung ueberzeugter EnthusiastInnen in den Burnout schicken. Denjenigen, die daraus dann eine Buehne machen, hat das bislang selten geschadet. Ich wuerde aber gerne endlich mal wieder die Sache im Vordergrund sehen.
Das ist aus zwei Gründen bemerkenswert. Erstens wegen des GovTech-Campus selbst, seiner Organisation als eingetragener Verein, in dem Unternehmen für mehrere tausend Euro Mitglied werden können, und der Tatsache, dass dort Ministerien und privatwirtschaftliche Dienstleister unter demselben Dach sitzen und „gemeinsam“ IT-Dienstleistungen entwickeln. Die Lage hebt das als positives Beispiel hervor. Zweitens, weil eher im Nebensatz erwähnt wird, dass es seit vielen Jahren auch eine aktive digitale Zivilgesellschaft in diesem Bereich gibt. Die ehrenamtliche Zivilgesellschaft hat im Konzept des GovTech-Campus aber gar keinen Raum, und wird in der Lage auch nur im Rahmen von Hackathons erwähnt, die an den Bedürfnissen vorbei entwickeln würden.
Derweil kann man argumentieren, dass die Situation, in der die öffentliche Hand bei ihren Digitalisierungsbestrebungen stets auf externe Dienstleister angewiesen ist und mit der Zivilgesellschaft allenfalls im Rahmen von Hackathons interagieren kann, eine Konsequenz des New Public Management ist. In diesem Denkmodell wird die Bevölkerung zu „Kund*innen“ des Staats, der sich – auch in genuinen Aufgaben der Daseinsvorsorge – wie ein Unternehmen verhalten soll. Das heißt zum Beispiel, dass Abteilungen sich untereinander ihre Leistungen in Rechnung stellen. Aber auch, dass Leistungen der öffentlichen Hand an Unternehmen oder eigene Gesellschaften ausgelagert werden. Ein Engagement außerhalb dieser Wirtschaftslogik ist gar nicht vorgesehen – das heißt, die umfangreiche praktische Digitalisierungsexpertise aus dem Ehrenamt zerschellt regelmäßig an der staatlichen Organisationspraxis.
Schon für die Anforderungsbeschreibung von Digitalprojekten braucht es externe Beratung
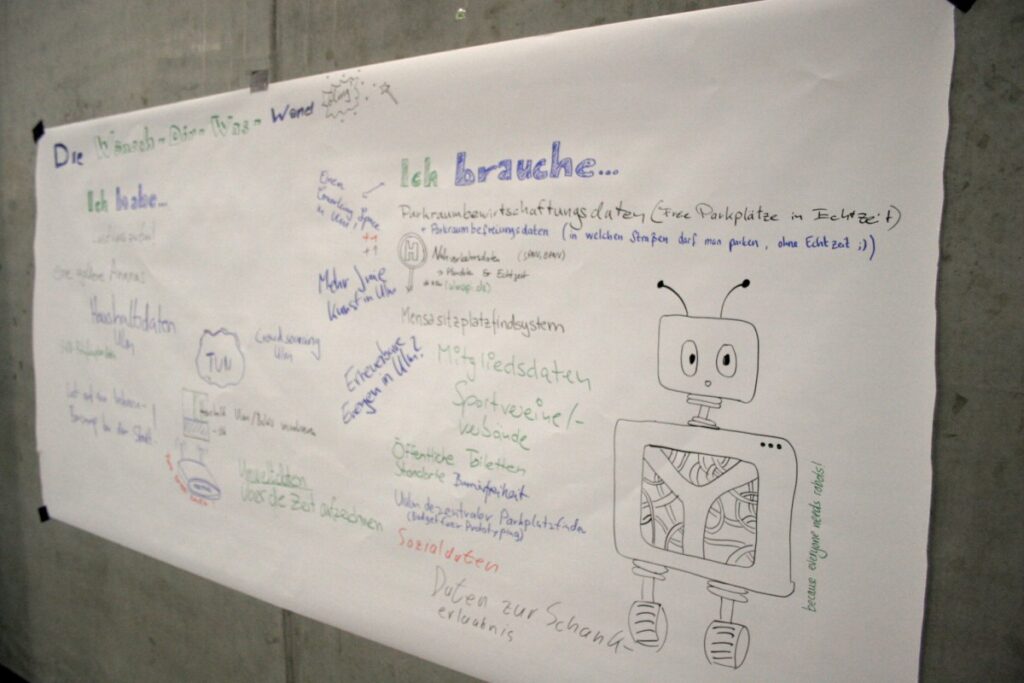
Wünschewand beim OpenCityCamp 2012
Das hatte gerade für die Digitalisierung fatale Folgen. Anstatt IT-Architekturkompetenzen auf allen Ebenen der föderalen Verwaltung aufzubauen, bestimmt seit Jahren eine Reihe externer Dienstleister, wohin der Staat digitalisiert. Was auf den ersten Blick wie eine Effizienzsteigerung klingt – denn natürlich sollen nicht über 11000 Kommunen jeweils ihre eigene Softwarelösungen entwickeln – führte über die Jahre zu einem weitreichenden Kompetenzverlust schon bei der Bestimmung, was eigentlich die Anforderung an die zu bauenden Softwarearchitekturen sind. Als Nebeneffekt kann es dann auch schon einmal vorkommen, dass die beschaffte Software am Ende gar nicht für den gedachten Einsatzzweck taugt und das Projekt für die Katz war. Lilith Wittmann nennt das in ihrer kritischen Besprechung des GovTech-Campus die „Beratertreppe“: Die laufende Externalisierung von Kompetenzen wurde zur selbstverstärkenden Spirale, so dass seit Langem schon für die Erstellung der Ausschreibungen für ein Softwareprodukt externe Beratung herangezogen werden muss.
Diese Erfahrung haben in den vergangenen Jahrzehnten auch immer wieder Ehrenamtliche aus der Zivilgesellschaft gemacht. Analog zur Civic-Tech-Bewegung in den Vereinigten Staaten entstanden in den späten 2000er-Jahren auch in Deutschland Gruppen Freiwilliger, die am praktischen Beispiel aufzeigten, was mit den Mitteln der Informationstechnik eigentlich möglich wäre. Als Instrument der Selbstermächtigung und zivilgesellschaftlichem Gegenstück zu Open Government entstanden Transparenz fördernde Auswertungen offener Daten, aber auch ausgereifte Beispiele, wie die öffentliche Hand ihre Leistungen für die Bevölkerung noch besser benutzbar machen kann.
All diese Gruppen stießen jedoch früher oder später auf die immer selben strukturellen Hürden, wenn es darum ging, dass der Staat ihre Ideen auch aufgreift und sich zu eigen macht. In ihrem Buch „A civic technologist’s practice guide“ beschreibt die ehemalige leitende 18F-Mitarbeiterin Cyd Harell zwei notwendige Schritte für die erfolgreiche Anwendung von Civic Tech: „Showing what’s possible, and doing what’s necessary“. Dieser Pfad, dass Ehrenamtliche aus der Zivilgesellschaft zeigen, was möglich wäre, und der Staat dann das Notwendige tut, um sich diese Beispiele zu eigen zu machen, scheint in Deutschland aber fast nirgendwo vorgesehen zu sein. Meist ist man entweder zivilgesellschaftliche „Kund*in“ des Staats und kann allenfalls im Rahmen von Anhörungen und Feedbackrunden Jahr für Jahr dieselben Post-Its auf Metaplanwände kleben – oder man muss selbst Dienstleister*in werden und sich beauftragen lassen, der eigenen Idee irgendwo im Wildwuchs der Verwaltungs-IT ein Gärtchen bestellen zu dürfen.
Für gestaltende Zivilgesellschaft ohne wirtschaftliches Interesse gibt es in diesem Denkmodell keinen Raum
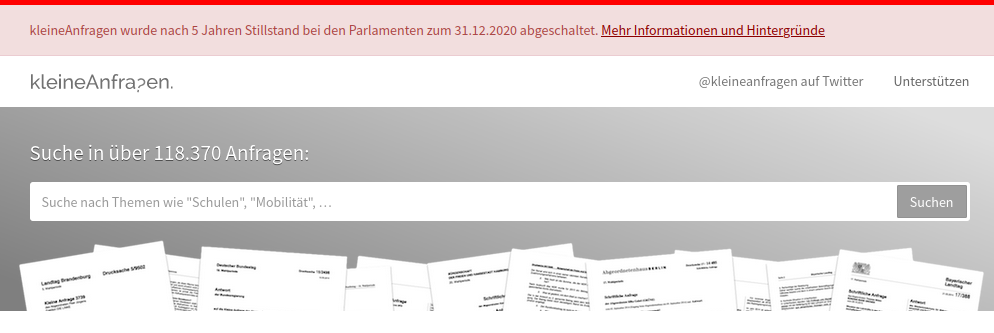
kleineAnfragen.de: 2014–2020
Für die Unterstützung der Umsetzer-Rollen gab es über die Jahre verschiedene Ansätze: Inkubatorprogramme, Förderlinien, Kooperationen mit Umsetzungspartnern aus der Wirtschaft. Das waren aber allesamt lediglich unterschiedliche Geschmacksrichtungen entweder von Firmengründungen oder kurz- bis mittelfristigen finanziellen Förderungen, damit Weiterentwicklung und vor allem Wartung und langfristiger Betrieb wenigstens nicht in der Freizeit der Beteiligten passieren musste. Wir haben im Ergebnis bis heute keinen Ansatz, um langfristig einen Pfad zu ebnen, dass die öffentliche Hand selbst fertige, von der öffentlichen Hand direkt übernehmbare Produkte wie kleineanfragen.de auch selber betreiben könnte, und sei es über Konstrukte wie die kommunalen Rechenzentrumsverbünde. An die Stelle von Civic Tech aus einer engagierten Bürgerschaft und einer Verwaltung, die selbst in der Lage ist, aus deren Erfahrungen zu lernen, ist GovTech getreten – also die vollständige Abhängigkeit von Firmen, die teils den Staat als einzigen Kunden für ihre Produkte haben.
Das ist auch eine Erfahrung der Zivilgesellschaft aus jahrelanger Beschäftigung im Austausch mit der Verwaltung – sei es bei selbst organisierten Barcamps oder der Beteiligung an Hackathon-Formaten. Und hier zeigt sich eine weitere problematische Konsequenz dieser Kompetenzauslagerung durch den Staat. Eher im Nebensatz erwähnt Philip Banse, dass es neben dem ebenfalls auf dem GovTech-Campus vertretenen Digital Service des Bunds auch Ehrenamtsnetzwerke wie Code for Germany gebe – aber die würden ja eher Hackathons machen und an den Bedarfen der öffentlichen Hand vorbei entwickeln.
Aus Sprints werden Marathons – aber warum sollen Ehrenamtliche laufen, und nicht der Staat?
Indes waren es gerade die Ehrenamtlichen des Code-for-Germany-Netzwerk, die auf den Nachhall des großen Corona-Hackathons der Bundesregierung 2020 in Form einer Wiederentdeckung von Hackathons durch die öffentliche Hand und seinen Partnerorganisationen wie Tech4Germany (aus dem der oben erwähnte Digital Service hervorging) eher verhalten reagierten. Viele der Code-for-Germany-Aktiven haben über die Jahre hinweg Begegnungen mit Hackathonformaten gehabt – und merkten über die Zeit, dass sie zwar an Erfahrung dazulernten, wie die Verwaltung funktioniert, aber immer wieder auf dieselben Probleme und Hilflosigkeiten dieser Verwaltung stießen, die schon auf den Austauschformaten mehrere Jahre zuvor adressiert werden sollen hätten. Die Erfahrung der Code-for-Germany-Ehrenamtlichen zeige, „dass es weniger um die Prototypen als viel mehr [um] Erkenntnisse auf einer strukturellen Ebene“ gehe, heißt es in einer Handreichung des Netzwerks vom Sommer 2020.
Zum einen geht es bei Hackathons wegen des immer noch vielfach genutzten Wettbewerbscharakters nämlich viel zu häufig um den Start neuer Projekte. Häufig werden also Ideen neu erfunden, an denen andere Gruppen bereits – beispielsweise aus eigener Betroffenheit – zur Verbesserung einer konkreten Situation gearbeitet haben und nun Unterstützung zur Weiterentwicklung und Wartung gebrauchen könnten. Zum anderen laufen auch die „Verstetigungsprogramme“ bis heute meist auf die finanzielle Unterstützung der Ideengeber*innen oder die Entwicklung der Ideen in ein Geschäftsmodell hinaus. Aus dem Sprint werde ein Marathon, hieß es im Nachgang des Corona-Hackathons – ohne dabei die Frage zu stellen, warum denn nun ausgerechnet die Zivilgesellschaft einen Marathon laufen soll, und nicht der Staat.
Die ausgearbeiteten Lösungen aus dem Digitalen Ehrenamt liegen meist schon vor – haben aber selten Chance, zu verfangen
So stellte eine Kommune die Herausforderung vor, die Beschlüsse des Gemeinderats „erlebbarer, einfacher auffindbar und transparenter“ zu machen. Das Ratsinformationssystem der Kommune habe in der Regel Schnittstellen, um diese Informationen abrufen und beispielsweise auf einer Karte darstellen zu können. Bei der beschriebenen Schnittstelle handelt es sich um den seit 2012 durch Ehrenamtliche bei Code for Germany entwickelten Standard OParl. Und die Ironie der Challenge ist, dass, wie gerade erst von Nora Titz beschrieben, am Anfang dieser Standardisierung genau solche grafischen Aufbereitungen der Ratsinformationen standen – damals mit Scrapern aus den Informationssystemen extrahiert und beispielsweise auf Karten dargestellt. Die für die Öffentlichkeit nutzbaren, im Ehrenamt entwickelten Frontends für die Auswertung der OParl-Daten konnten bis heute nicht von der öffentlichen Hand übernommen, geschweige denn betrieben werden. Teilweise scheint es ihr schon schwerzufallen, die beim Ratsinformationssystem-Anbieter bestellte OParl-Schnittstelle auch auf ihre korrekte Installation zu überprüfen und abzunehmen. Die OParl-Schnittstelle der Challenge-gebenden Stadt war zum Zeitpunkt des Hackathons gar nicht aktiviert – und ist es auch zum Zeitpunkt dieses Artikels noch nicht. Es existiert zwar ein fertiges Validierungsskript, mit dessen Hilfe man die Standardkonformität der Schnittstelle in Minutenschnelle prüfen kann. Um dieses Skript bei der Abnahme im Verwaltungsnetz ausführen zu können, bedarf es aber der internen Fähigkeiten, den Validator auf Verwaltungsrechnern selbst zum Laufen zu bringen. Danach braucht es noch etwas Verständnis, die Ausgaben interpretieren zu können und sich vom Dienstleister nicht einreden zu lassen, dass der Fehler bei einem selber liege. Was engagierten Freiwilligen mit grundlegenden Kenntnissen eine spielerische Fingerübung weniger Minuten ist, stellt die Verwaltung teilweise heute noch vor große Herausforderungen. Der Staat baut hier nicht die notwendigen Kompetenzen in der Breite auf, um die gratis vom Ehrenamt gelieferten Skripte auch selbstbestimmt ausführen zu können. Stattdessen sind diese Ehrenamtlichen letztlich dazu gezwungen, selbst als bezahlte Dienstleister*innen aufzutreten, wenn sie wollen, dass ihre Ideen auch in die Tat umgesetzt werden.
Vorhandenes Wissen aufgreifen und dokumentieren – nach den Bedürfnissen des Ehrenamts!
Die überstarke Begeisterung des Staats für Hackathons scheint mittlerweile – zum Glück! – endlich abzuflauen. Offen bleibt aber die Frage, wie Ehrenamt und Zivilgesellschaft sich überhaupt wirkungsvoll mit ihrer Expertise einbringen können. Der Anspruch kann dabei nicht sein, auch als Zivilgesellschaft ein Büro am GovTech-Campus zu haben. Schon die Existenz eines GovTech-Marktes ist mehr Indikator eines grundsätzlichen Problems, als dass diesem Markt mit einem Austauschcampus noch niederschwelligerer Zugang geschaffen werden soll. Es kann auch nicht die Aufgabe Ehrenamtlicher sein, werktags mit am Tisch zu sitzen, wenn Vergabeverfahren für staatliche IT-Lösungen nun möglicherweise noch weniger nachvollziehbarer als bisher zwischen Verwaltung und Dienstleistern ausgehandelt werden. Vielmehr geht es darum, den Wissensschatz der ehrenamtlichen Digitalen Zivilgesellschaft aktiv zu suchen und in die Verwaltung selbst zu transferieren.
Wikimedia Deutschland hat gemeinsam ergänzt um Interviews mit der Deutschen Stiftung für Ehrenamt und Engagement vergangene Woche im Politikbrief „Digitales Ehrenamt: Zivilgesellschaftliche Teilhabe im Digitalen Raum“ sechs Forderungen aufgestellt, wie dieses Engagement besser vom Staat gewürdigt und gefördert werden sollte. Eine der Forderungen ist der systematische Transfer ehrenamtlicher Expertise. Der Staat sollte nicht etwa Dienstleister*innen auf seinen GovTech-Campus zu sich einladen und damit weiter Kompetenzen externalisieren, sondern strategisch interne IT-Fähigkeiten aufbauen. Das vorhandene Wissen im digitalen Ehrenamt muss durch aufsuchende Beteiligung und den Bedürfnissen der Freiwilligen folgend aufgegriffen und dokumentiert werden, um es verwaltungsintern verwendbar und anwendbar zu machen. Damit könnte endlich eine Brücke über die nach wie vor bestehenden Wissensklüfte geschlagen werden – damit kommende Generationen ehrenamtlich Aktiver hoffentlich künftig nicht mehr zu ihrer Frustration auf dieselben strukturellen Hürden stoßen, an denen diese Partizipation bislang scheiterte.
//edit am 24. Januar 2023, Rolle der DSEE im Politikbrief von WMDE korrigiert
Ab 09:27 kommt im Video ein anschauliches Beispiel des dahinter liegenden Paradigmenwechsels. Anstelle von Apps, die auf hardcodierte APIs zugreifen muessen (und die dann wieder angeflanscht an zentralisierte Datensilos sind), werden Abfragen im dezentralen Modell lokal synthetisiert. Die notwendigen Daten kommen dann aus denjenigen verteilten Quellen, die fuer genau diese Frage notwendig sind.
In Ergaenzung (und technisch notwenige Voraussetzung) zum auf den Kopf gestellten Nutzungsversprechen von Open Data erlaubt diese Herangehensweise eine Abkehr von zentralisierten Superdatenplattformen. Die bisherige Idee war, dass es ja eine Vielzahl von Fachverfahren gebe, deren Daten in einzelnen Silos liegen. Um das aufzubrechen muessten Verfahren standardisiert werden und alle Daten in ein zentrales Silo anliefern. Was auch bedeutet, dass z.B. einzelne Kommunen oder Bezirke ihre bisherigen Fachverfahren fuer ein Thema aufgeben und sich der Mehrheit anschliessen muesten – und sei es mit Zwang. Im Gegenmodell waere die interne Datenhaltung oder zumindest das Ergebnis eines ETL-Prozesses der Fachverfahrensdaten ein Knowledge Graph – und ueber verteilte Knowledge Graphs lassen sich wie im Video demonstriert wunderbar Abfragen fahren, nur durch die Magie von 5-Sterne-Daten mit Semantik. Die Bausteine dafuer sind mittlerweile Jahrzehnte alt und gut abgehangen. Und eigentlich passt das auch viel besser in das Modell eines foederalen Staats, der nicht alles von oben her vereinheitlicht und nach oben hin an sich zieht, sondern auf den Ebenen auch Entscheidungsspielraeume laesst.
Lilith Wittmann ist wie immer gleich deutlich radikaler und sagt: Alles bis drei Sterne sollte eigentlich gar nicht mehr zaehlen, wir muessten noch weiter gehen und Open Data erst ab vier Sternen ueberhaupt „zaehlen“ lassen:
Replying to @LilithWittmann
Das Problem ist aber: Wir haben seit 15 Jahren dieselbe Vision, bei der alles ab Schritt 4 in weiter Ferne erscheint. Und gerade in Deutschland kam nie irgendwas über 3⋆ hinaus.
Deshalb schlage ich heute eine neue Version von 5⋆ #OpenData vor.
Toris Post war mir jetzt endlich aufraffender Anlass, verschiedene Textstuecke zusammenzustellen, die ich seit einer Weile vor mir herschiebe, und im Mai war das nun endlich alles so weit, dass ich einen ersten Entwurf beim Kommunalen Open Data Barcamp vortragen konnte. Denn dieser Fokus „die oeffentliche Hand soll Open Data bereitstellen, damit Dritte irgendetwas damit tun“ ist einer der fundamentalsten Missverstaendnisse des letzten Jahrzehnts in dieser Szene. Und ich fuerchte, dieses Missverstaendnis sabotiert seit Jahren die eigentlich anzugehenden Aufgaben.
Eine Quelle dieses Missverstaendnis koennte das typische “Showing what’s possible“-Muster aus dem Digitalen Ehrenamt sein. An einem konkreten Beispiel wird gezeigt, was mit offenen APIs und/oder offenen Daten oder einem besseren User Interface moeglich waere. Dabei ist beinahe egal, ob man nun einen bestehenden Dienst besser macht (wie z.B. kleineanfragen.de das tat), oder ob man an einem ganz konkreten Beispiel (fuer das man irgendwie an Datenpunkte kam) ein anschaulich nutzbares Produkt baut, wie die Trinkwasser-App.
Ende November hatten wir im Netzwerk Code for Germany einmal versucht, typische Aktivitaeten der lokalen Open-Data-Arbeitsgruppen einzuordnen, und an vielen Stellen kam dieses „showing what’s possible“ zur Sprache. Menschen machen das aus den verschiedensten Beweggruenden: Weil sie selber einen praktischen Anwendungsfall fuer das Ergebnis haben. Weil sie zeigen wollen, was geht. Oder einfach auch nur aus Spass.
An vielen Orten entstanden genau so vor ca. 10 Jahren die ersten veroeffentlichten Datensaetze. In Ulm hatte die Gruppe Engagierter einzelne Datensaetze per Mail von der Stadtverwaltung erhalten, und beispielsweise die Geodaten der Stadtbezirke selber zum Download und ueber eine CouchDB ausgespielt, und in Click-that-Hood praktisch erfahrbar gemacht.
Andere Staedte sprangen auf den „Trend“ auf. Datensaetze wurden immer noch haendisch herausgesucht und veroeffentlicht – und meist orientierte man sich dabei an den Datensaetzen, die bereits anderswo veroeffentlicht oder gar in einen praktischen Anwendungskontext bezogen wurden. Und nebenbei glaubte man, dass Datenportale hermuessten, Metadatenbeschreibungen fuer jede Excel-Liste im Datenportal wurden umstaendlich gepflegt, und viel dergleichen haendische Arbeit mehr.
Auf der zivilgesellschaftlich engagierten Seite entstand dadurch der empfundene Druck, die bisherigen Konzeptprototypen und Showcases zu „redeployen“. Anderswo gab es nun auch Stadtbezirks-Geoshapes, Trinkwasserinformationen und dergleichen mehr. Also, war die Annahme, muesse man die aktuellen Daten nun auch in einen lokalen Ableger dieser Showcases einpflegen. Gleichzeitig stieg die Erwartung, dass diese Beispielvisualisierungen auch auf lange Frist unterhalten und gepflegt werden wuerden. Und an den Orten, an denen sich niemand auf die aufwaendig bereitgestellten Daten stuerzte, war die Enttaeuschung gross. Denn wofuer macht man sich ueberhaupt den Aufwand?
Eigentlich seltsam, denn die Metapher ging ja eigentlich schon lange dahin, dass die Bereitstellung offener Daten so etwas wie ein automatisierter Containerhafen werden sollte – derweil die Daten immer noch wie haendisches Stueckgut aus den Fachverfahren und Excel-Listen herausgetragen werden.
Und da sind wir eigentlich am Kernproblem: An viel zu vielen Stellen wird haendisches oder maessig automatisiertes 3-Sterne-Open-Data immer noch als akzeptables Zwischenziel angesehen.
Wir erinnern uns aus dem Covid-Daten-Beispiel: Bis zu 3-Sterne-Daten kommen als CSV daher – ohne Informationen, was eigentlich in welcher Spalte steht und was das sein soll. Ist es ein Datum? Ein Strassenname? Die Zahl der Infizierten am gestrigen Tag? Wenn ich das auswerten will, muss ich das meinem Parser erst einmal haendisch pro Spalte beibringen. Und wenn das RKI die Reihenfolge der Spalten aendert, faellt der Parser auf die Nase.
Ich glaube, dass all das damit zusammenhaengt, dass in der Regel intern gar nicht die Voraussetzungen vorhanden sind, um mit diesen Daten in groesserem Umfang etwas anzufangen. Die Listen sind Datenbasis fuer (haendisch erstellte) Reports, (haendisch erstellte) Schaubilder, aber es sind weder die notwendigen Werkzeuge noch die notwendigen Infrastrukturen vorhanden, um schon verwaltungsintern Daten ueberhaupt strukturiert abzulegen und dann an anderer Stelle damit zu arbeiten – idealerweise mit dem Ziel eines Knowlege Graphs fuer 5-Sterne-Open-Data.
Und gerade weil die notwendige Voraussetzung fuer die Herstellung eines solchen Zustands eine hervorragende IT-Infrastruktur auf dem Stand der Technik ist, muessen wir die bisherigen Herangehensweisen weitgehend auf den Kopf stellen. Bisherige Beispielkataloge, was denn ueberhaupt als Open Data veroeffentlicht werden koennte, orientieren sich meist daran, was anderswo da war. Das waren aber eben entweder die beruechtigten “Low Hanging Fruits”, oder eben Datensaetze fuer die genannten Proofs of Concept. Das ist aber meist komplett losgeloest von einer internen Nutzung, die ueberhaupt erst die Motivation und den Anlass geben koennte, die dafuer notwendigen Strukturen aufzubauen. Idealerweise wuerde eine Strategie nicht damit beginnen, die hunderten Fachverfahren zu kartieren und wie man deren Daten per ETL herauskratzen kann. Sondern (mit einer klaren Strategie zu Linked Open Data im Kopf!) praktische Anwendungsfaelle zu finden, in denen Einheit A intern Daten braeuchte, die Einheit B bislang unstrukturiert ablegt oder auf Zuruf aufbereitet – und dann beginnt, Prozesse fuer die automatische Verdatung zu bauen. Inklusive des Aufbaus der notwendigen Kompetenzen und des Unterbaus, um das selber machen zu koennen oder zumindest den Weg dahin kompetent selbst zu bestimmen. Open Data darf kein Mehraufwand sein, sondern faellt quasi als Abfallprodukt aus besseren Prozessen heraus – wer etwas veraktet, produziert automatisch Linked Data, das bereits behoerdenintern nachgenutzt werden kann. Der Open-Teil ist dann „nur“ noch eine Frage dessen, was nach aussen veroeffentlicht werden soll.
Ich sass heute Vormittag in einem Forschungsinterview, in dem der Interviewer eher beilaeufig einen Satz fallen liess, der mich nun den ganzen Tag nicht mehr losgelassen hat.
Eigentlich sprachen wir ueber die Mobility Data Specification, die sich einige US-Staedte ausgedacht hatten, um Shared-Mobility-Anbieter datengetrieben regulieren und steuern zu koennen. In den USA ist die relativ weit verbreitet, und die Staedte oder regionale Zusammenschluesse wie SANDAG betreiben auch die dafuer notwendige Infrastruktur selber, um beispielsweise die gewuenschten Geschaeftsgebiete, Ausschlusszonen etc. maschinenlesbar auszuliefern und die geforderten Statistikdaten entgegennehmen und in die Stadtplanung einfliessen zu lassen. In Europa hingegen erfaehrt das bislang nur eine sehr bruchstueckhafte Nutzung. Ich kenne derzeit keine Stadt in Deutschland, die die Daten bislang wirklich direkt in den Planungsprozess einbezieht – und sei es, indem sie einen der mittlerweile vorhandenen Dienstleister als Datenclearingstelle nutzen.
Der Interviewer kommt selbst aus dem Open-Transport-Feld und hat lange Jahre Erfahrung im ODIN-Netzwerk gesammelt (witzigerweise hatte ich noch einige Mails von ihm aus der OKF-Transport-Mailingliste von 2012 im Mailarchiv). Irgendwann meinte er: Die US-Staedte koennen vieles vielleicht deswegen besser selber intern loesen, weil die ja nicht so viel Geld haben, im Vergleich.
Das rumort jetzt eine Weile in mir, weil es ja intuitiv widerspruechlich erscheint, aber das Problem sehr sehr praegnant auf den Punkt bringt. Wenn die US-Kommunen weniger gut finanziell ausgestattet sind (was ich nicht geprueft habe, stellen wir es mal als These hin), muessen sie viel mehr auf eigene Kompetenzen setzen und diese strategisch gut aufbauen, um Digitalloesungen auch sinnvoll zum Fliegen zu bekommen.
Lilith Wittmann hatte heute einen von ihr fuer das ddb-Magazin geschriebenen Gastbeitrag (Ausgabe 12/2021, Seite 18) vertwittert, in dem sie nochmal sehr treffend den normalen Umgang deutscher Verwaltungen mit diesem Themenfeld beschreibt. Auszug:
Dieser verhängnisvollen Allianz zugrunde liegt der politische Irrweg, Digitalisierung eben genau nicht als den Kulturwandel zu begreifen, der erforderlich ist, um sie in der Verwaltung erfolgreich umzusetzen. Stattdessen wird der moderne Staat weiter als „Projekt“ angegangen: Es werden keine neuen Stellen für Menschen mit IT-Knowhow geschaffen, sondern Millionen für externe Projektunterstützung ausgegeben. Die Leitung von Digitalprojekten geht regelmäßig an eine Referatsleitung, die schon andere Projekte erfolgreich durchgeführt hat – wer Förderleitlinien schreiben kann oder mal Pressesprecher war, der bekommt dieses Digitalisierungsding doch bestimmt auch hin.
Was aber sollen nun Menschen ohne Vorerfahrung mit solch hochkomplexen und technisch anspruchsvollen Themen in so einer Projektsituation anderes machen als sich externe Hilfe zu holen? Also fragt man zum Beispiel Capgemini an – für Konzept und Ausschreibung. Und wenn sie schon mal dabei sind, können sie direkt die Projektsteuerung mit machen. Capgemini hat für die technische Umsetzung gute Erfahrungen mit IBM. Also holt man die dafür ins Boot. Und PwC übernimmt die Rechtsberatung – hat man ja schon immer so gemacht.
Ausreichend viele faehige Menschen mit Wissen um IT-Architekturen einzustellen, scheitert derweil viel zu oft am immer selben Endgegner: Dem Stellenplan. Die bisherige IT ist schon vollauf damit beschaeftigt, die historisch gewachsenen Systeme zu baendigen und halbwegs rechtzeitig auf CVEs in der Firewall oder dem Exchange-Server zu reagieren. Und fuer weitere, gut qualifizierte und entsprechend im Wettbewerb nur mit entsprechender Besoldung zu haltende Kraefte gibt’s keine Stelle im Stellenplan, und vor allem kein Geld.
Macht aber nix, weil es ja genuegend Fuellhoerner fuer Leuchtturmprojekte und Vorzeigedigitalisierung gibt, aus denen dann die notwendigen Sachmittel fuer externe BeraterInnen fallen. Und das Externalisierungskarussell dreht sich eine Runde weiter.
Das ist ein wenig wie das alte Klischee vom oeffentlichen Bau, bei dem man an der Daemmung gespart hat und man eigentlich direkt zum Fenster hinausheizt: Im Finanzhaushalt (fuer Investitionen) haetten die besseren Fenster zu viel mehr gekostet. Und dass man das in 10 Jahren bei den Heizkosten wieder drin haette und die darauf folgenden 20 Jahre viel einsparen wuerde, betrifft ja nur den Ergebnishaushalt fuer die laufenden Betriebskosten.
Nach den Aha-Momenten zu Logomachie und einer zunehmenden Grantigkeit ueber die inflationaere Verwendung des immer sinnentleerter wirkenden Begriffs der „Digitalen Souveraenitaet“ hatte ich ueber den Sommer einige Paper zum Begriff gelesen, die mir durch die Timeline flatterten. Den Aufschlag machte IIRC dieses Papier von Julia Pohle, und ich habe dann wie so oft eine groessere Menge offener Browsertabs angesammelt, die ich ueber ein halbes Jahr mit mir herumschleppte.
Wesentlicher Antreiber der Debatte sind Vorhaben der Europaeischen Union, irgendwie „digital souveraener“ zu werden – man koennte meinen, im klassischen Sinn der Staatssouveraenitaet, der auf einem definierten territorialen Gebiet basiert, das es gegen ein Aussen abzugrenzen und offenbar auch abzuschotten gilt. Theodore Christakis geht in einem halben Buch auf die verschiedensten Auspraegungen ein, was das alles bedeuten soll: Wird das so etwas wie das bisher immer scharf kritisierte Modell der chinesischen Internetregulierung? Geht es um strategische Autonomie in Bereichen der Tech-Branche? Quasi eine europaeische Digital-Juche-Ideologie?
Auch irgendwie souveraen, aber halt anders
Gleichzeitig wird der Begriff bereits seit einiger Zeit in eher aktivistischen Kreisen verwendet, die ihn mit einem Begriff individueller oder kollektivistischer Autonomie besetzen. Im Herbst 2019 hatten Stephan Couture und Sophie Toupin (DOI 10.1177/1461444819865984, SciHub *hust) die Verwendung des Begriffs in englischen und (wenigen) franzoesischen Texten ausgewertet, und sie zu klassifizieren versucht. Angefangen von der altbekannten Declaration of Independence of Cyberspace (1996) reicht ihr Spektrum ebenfalls ueber das der Staatssouveraenitaet, aber auch Souveraenitaetsbestreben indigener Voelker in der digitalen Domaene, bis zur aktivistischen Verwendung. Der aktivistische Begriffsgebrauch ist dabei ein voellig anderer als der, den sich die EU beispielsweise bei GAIA-X vorstellt – vielmehr sollten mit Freier/Open-Source-Software und -Hardware Mittel zur Selbstermaechtigung geschaffen werden, ohne auf kommerzielle Angebote angewiesen zu sein. Wir kennen die Slogans: „Program or be Programmed“, oder „ein Geraet gehoert nur dir, wenn du es unter Kontrolle hast“, etc.
Zuletzt gehen die AutorInnen auf Persoenliche Digitale Souveraenitaet ein, als Eigenschaft oder Faehigkeit eines Individuums, Kontrolle ueber eigene Geraete, Daten, Hardware etc auszuueben – oder aber als Parallele zur koerperlichen Autonomie, wie sie auch in feministischen Diskursen verstanden werden kann.
Was jetzt, Staat oder Individuum?
Wir haben es also mit konkurrierenden Definitionen desselben Begriffs zu tun, der aber im politischen Raum von Gruppen verwendet wird, denen ich hoechst unterschiedliche Zielsetzungen unterstellen wuerde. Das ist ja schon einmal ein guter Einstieg.
Auf der Suche, genauer herauszufinden, was denn die moeglichst genaue staatliche Definition ist, gaebe es einmal die eher sachliche Variante:
1) it possesses authority; 2) this authority is derived “from some mutually acknowledged source of legitimacy”—which can be God, a constitution, or a hereditary law; 3) this authority is supreme; and 4) this authority is over a territory
The year 1648 haunts everyone participating in the current Internet governance and digital sovereignty debate. But why is something that happened 373 years ago relevant for the debate? In 1648 the Peace of Westphalia was signed.
Waehrend das Westfaelische System naemlich durchaus fuer eine Definition staatlicher Souveraenitaet ausreicht, ist darin auch schon gleich das Kernproblem des Uebertrags ins Digitale umrissen. Man kann die Declaration of Independence of Cyberspace als 90er-Jahre-Cyberpunk-Romantik abtun, aber andersherum stoesst die Souveraenitaet von Staaten bei einem grenzueberschreitenden Konstrukt wie dem Internet ebenfalls an ihre (haha) Grenzen: Wenn die Autoritaet an ein Staatsterritorium gebunden ist, und mangels einer uebergeordneten Autoritaet das Zusammenspiel von Staaten an Freiwilligkeit gebunden ist: Ja wie soll denn das gehen mit der Souveraenitaet im Netz? Auch: Stimmt es ueberhaupt, dass ein Staat einem anderen innerhalb dessen Grenzen keine Vorgaben machen kann – weil er ist ja souveraen? Und falls das stimmt: Dann sind nicht wenige ebenfalls als irgendwas mit Souveraenitaet geframete Gesetze ja fuer die Katz, oder?
Ruohonen beschreibt beispielhaft die Schlagabtausche zwischen der EU und den USA als ein nicht endendes Ping-Pong-Spiel:
The game played is also good drama. Particularly jolly are the frequent episodes depicting the players swinging in slow motion even though the ball has been taken away from them; namely, by Schrems (I) in 2015 and Schrems (II) in 2020. […] With respect to ping, extraterritorial power—the ability of a sovereign to exert governmental actions in another sovereign’s realm without its consent—has long been a part of ping’s data protection legislation. […] That said, the same year the GDPR came into force, pong passed its Clarifying Lawful Overseas Use of Data Act (CLOUD Act). It provides pong’s authorities access to data stored in cloud services without the cumbersome mutual assistance treaty, effectively deprecating ping’s people constitutional protections provided by a jurisdiction where the data is stored
Aber selbst innerhalb des Framings der EU scheinen sich die TreiberInnen nicht auf eine der beiden Perspektiven (Staatlichkeit vs. Individuum) einigen zu koennen. In Foreign Policy kommentiert Tyson Barker: Europe Can’t Win the Tech War It Just Started. Geradezu beliebig werde der Begriff einmal mit persoenlicher Autonomie und Freiheitsrechten motiviert, und im naechsten Atemzug mit der uneingeschraenkten Herrschaft auf einem territorialen Gebiet. Und selbst das Territorialkonzept laesst sich willkuerlich in seiner Bedeutung ausdehnen: Sei es Standortfoerderung unter dem Deckmantel einer angeblich noetigen Autarkie; der Wunsch, auch irgendetwas wie DARPA zu haben; oder ein dumpf-nationalistisch klingendes “Taking back control” – bei dem man sich dann fragen kann, von wem man die denn zurueckhaben will und wie die da ueberhaupt erst gelandet ist.
Es mag sein, dass sich mit Begriffen wie der „Digitalen Souveraenitaet“ Opportunitaetsfenster auftun, „etwas gutes“ zu tun. Den Begriff staerker auf die individuelle Autonomie framen, und so weiter. Ich persoenlich moechte nicht so recht daran glauben und halte mich mittlerweile von dem Begriff fern.
Erstens, weil er in seiner Verwendung mehrfach in sich widerspruechlich ist und sich unter derselben Flagge komplett inkompatible Zielvorstellung versammeln, mit gegenlaeufigen Absichten.
Zweitens aber: Jede Verwendung eines aktuellen Hype-Begriffs zahlt letztlich darauf ein, dass das jeweilige Meme am Leben bleibt und weiter befeuert wird. Und selbst wenn man beste Absichten unterstellt, muss doch klar sein, dass man damit gleichzeitig auch eine Denkweise am Leben haelt, fuer die streng gesicherte territoriale Grenzen nicht nur im Netz eine Selbstverstaendlichkeit sind. Die Unterscheidung in ein „innen“ und „aussen”, in ein „wir” und ein „die“ ist fester Bestandteil des Konzepts. Und so sehr man ueber die Vorstellung laecheln kann, dass „unsere“ Daten irgendwie sicherer oder besser dran seien, wenn sie in den Grenzen „unseres“ Staatskonstrukts geparkt sind. So sehr man ueber Protektionismus und die Foerderung heimischer Firmen fuer unsinnige Projekte die Augen rollen mag. Man sollte sich darueber im Klaren sein, welches Meme man da mit ganz realen Konsequenzen fuer reale Menschen am Leben haelt.
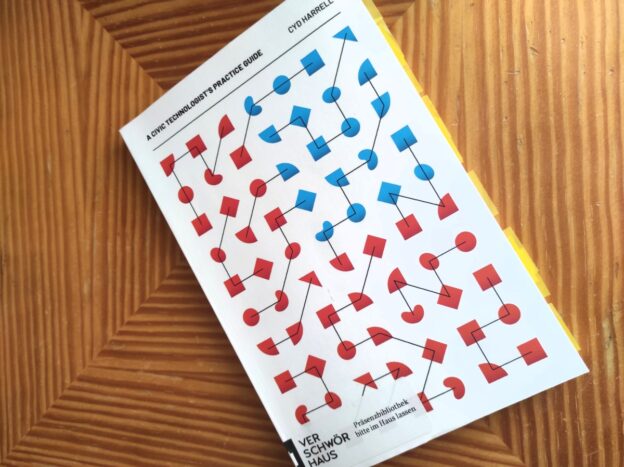
Die Civic-Tech-„Bewegung“ – so man ueberhaupt von einer sprechen kann, so vielfaeltig wie die Stroemungen sind – kommt langsam ins Pubertaetsalter. Um so ueberraschender, dass Buecher aus der Praxis wie der “Civic Technologist’s Practice Guide“ von Cyd Harrell immer noch so selten sind. Klar, in den ueblichen Fachbuchverlagen gibt es ganze Regalmeter voll mehr oder eher weniger nuetzlicher Handreichungen zu „Digitaler Transformation“, irgendwas mit Agil, oder Smart-City-Esoterik.
Harrell kann in ihrem Buch mit Stand 2020 aus acht Jahren eigener Praxiserfahrung im Maschinenraum berichten. Sie ist UX-Designerin und begann 2012 erst fuer das Center for Civic Design und danach das damals noch recht neu gegruendete Code for America zu arbeiten, bevor es sie zu 18F verschlug.
Max hat ein physisches Exemplar des Buchs gekauft, das gerade in meinem Umfeld die Runde macht, und nach meinem zweiten Durchlauf ist es gespickt mit Klebezetteln und Annotationen. Nicht etwa, weil man Dinge der Verstaendlichkeit halber annotieren muesste, im Gegenteil, die Sprache im Buch finde ich gut verstaendlich und nachvollziehbar. Ich hatte aber quasi alle drei Seiten einen „Ja, das ist gut umrissen und zusammengefasst, merken!“-Moment.
irgendwo da ist mal wieder eine Lektion versteckt, siehe pic.twitter.com/z7INexMnll und ich bin es wirklich, wirklich, wirklich leid, weil selbst die Instanzen, die Civic Tech zu foerdern vorgeben haben einfach Jahre lang nichts getan, die Basics in Ordnung zu bekommen.
Egal ob es die Frage ist, was Civic Tech eigentlich alles ist (ehrenamtliches Engagement, externe Unterstuetzung und Beratung der oeffentlichen Hand, interner Kompetenzaufbau in der Verwaltung – ja, alles davon), oder dass sowohl das „zeigen was geht“ als auch das „umsetzen, was es dafuer braucht“ gleichermassen zum Spiel gehoert. Viele in der Szene duerften schon laengst selbst zu diesen Erkenntnissen gekommen sein, zusammengefasst in einem Buechlein sind sie aber praktisch und gut weiterzugeben.
Der Blick auf die Erfahrungen in den USA lohnt sich ohnehin. Den Versuch, Fellows in die Verwaltung zu schicken, gab es dort bereits vor 10 Jahren(!), und auch viele andere Dinge, bei denen man aus den Erfahrungen von anderswo haette lernen koennen, wurden einfach in Deutschland nochmal neu von vorne gemacht. Erst durch das Buch lernte ich aber, dass in den USA bereits 2014 ein bekannter Venture Capitalist in die US-Civic-Tech-Szene einstieg und bereits laufende Programme einfach nochmal fuer sich neu erfand:
[It] took the civic tech community by surprise, but gained enormous mainstream press attention. It eventually disappeared […] without causing any significant change in the civic sphere, but it sufficiently distracted attention from the other groups working in the same space.
Ich hatte das Buch dann kurz weggelegt, aus dem Fenster geschaut und an hiesige „Social Entrepreneurs“ und Versprechen eines deutschen 18F gedacht und das war ein interessantes Emotiotop.
Im spaeteren Verlauf geht es dann aber auch wirklich ans Eingemachte, wenn man wirklich Dinge modernisieren will in einer Verwaltung und wie das ueberhaupt gehen soll, und hier zeigt sich der Kontrast zu ueblichen „ja da machen wir halt bissel was mit agil“-Simulationen. Laeuft das Schwarzbrotgeschaeft als Unterbau ueberhaupt rund, wer operationalisiert spaeter die schoenen Prototoypen, sind genuegend Ressourcen da, um Legacy-Systeme zu analysieren und sie falls noetig auch aendern zu koennen. Ueberhaupt, wie wird das Verwaltungssystem langfristig befaehigt, selbstaendig in die Zukunft blicken und die naechste oder gar uebernaechste technologische oder infrastrukturelle Huerde zu nehmen, ohne sich dabei aufs Gesicht zu legen und das womoeglich noch als Erfolg zu verkaufen? (Das mit dem selbstaendig Huerden meistern waere nebenbei die erste Definition einer „Souveraenitaet“, die ich tatsaechlich sinnvoll faende)
An manchen Stellen musste ich schwer seufzen. Fuer Harrell ist es denk- und fragbar, ob eine Verwaltungseinheit selber Dienste in der Produktion faehrt. Dass es Test- und Releaseprozesse fuer Software und Dienste gibt. Umfassendes Monitoring von Verfuegbarkeit und Erfolg. Ich wuenschte, dass man die in deutschen Verwaltungen ueberhaupt als Teil strategischer Aufstellung verstuende.
Und deswegen schliesst das Buch mit einem eigenen Kapitel ueber seelisches Wohlbefinden. Dass es dessen bedarf, hat eine ganz eigene Note. Dass es Teil des Buchs ist, spricht fuer Harrell.
Das Buch ist als Kindle- und EPUB-Format fuer knapp 10 Dollar zu haben, oder fuer rund 20 Euro als Taschenbuch. Ich moechte es sehr empfehlen.